原子计数为什么还不是限流器
摘要| 一次接口突然涌入多个请求,最直观的保护办法是把次数写进 Redis:先读、加一、再保存。换成原子增量后,丢更新消失了,但时间窗口、重试和业务执行仍可能出错。沿着 Microi吾码AI 的缓存调用链看下去,会发现“计数正确”只回答一个问题;要把它用于限流,还必须说清谁被计数、何时清零,以及哪一步真正获得执行资格。
✦ 01|同一个数,两个请求都觉得自己读对了
假设当前次数为零,A 和 B 几乎同时读取它。A 算出一,B 也算出一,随后都把一写回。每个请求的局部计算都没错,最终值却漏掉了一次。这里的问题是读、计算、写入跨越了多个操作,期间允许其它请求插进来。
// 反例:仅用于解释竞争,不作为并发计数方案
var oldValue = Number(V8.Cache.HashGet('Demo:Count', 'attempts') || 0);
V8.Cache.HashSet('Demo:Count', 'attempts', String(oldValue + 1));
把这段脚本包进接口引擎,并不会自动让 Redis 的多个命令成为一个不可分割步骤。数据库事务解决的是它管理的数据库写入,也不等于替 Redis 补上事务。
关键区别| 单个请求按顺序执行,不代表多个请求合在一起仍按你的业务顺序执行。
✦ 02|原子增量修复的是哪一段
当前 V8.Cache 提供 HashIncrement。V8TenantCache 先处理租户 Key,再把增量交给底层缓存实现;两级缓存的 Hash 路径继续转发到 Redis,最终调用 Redis 客户端的 HashIncrement。这里的增量类型是 double,不能把它宣传成任意精度金额账本。
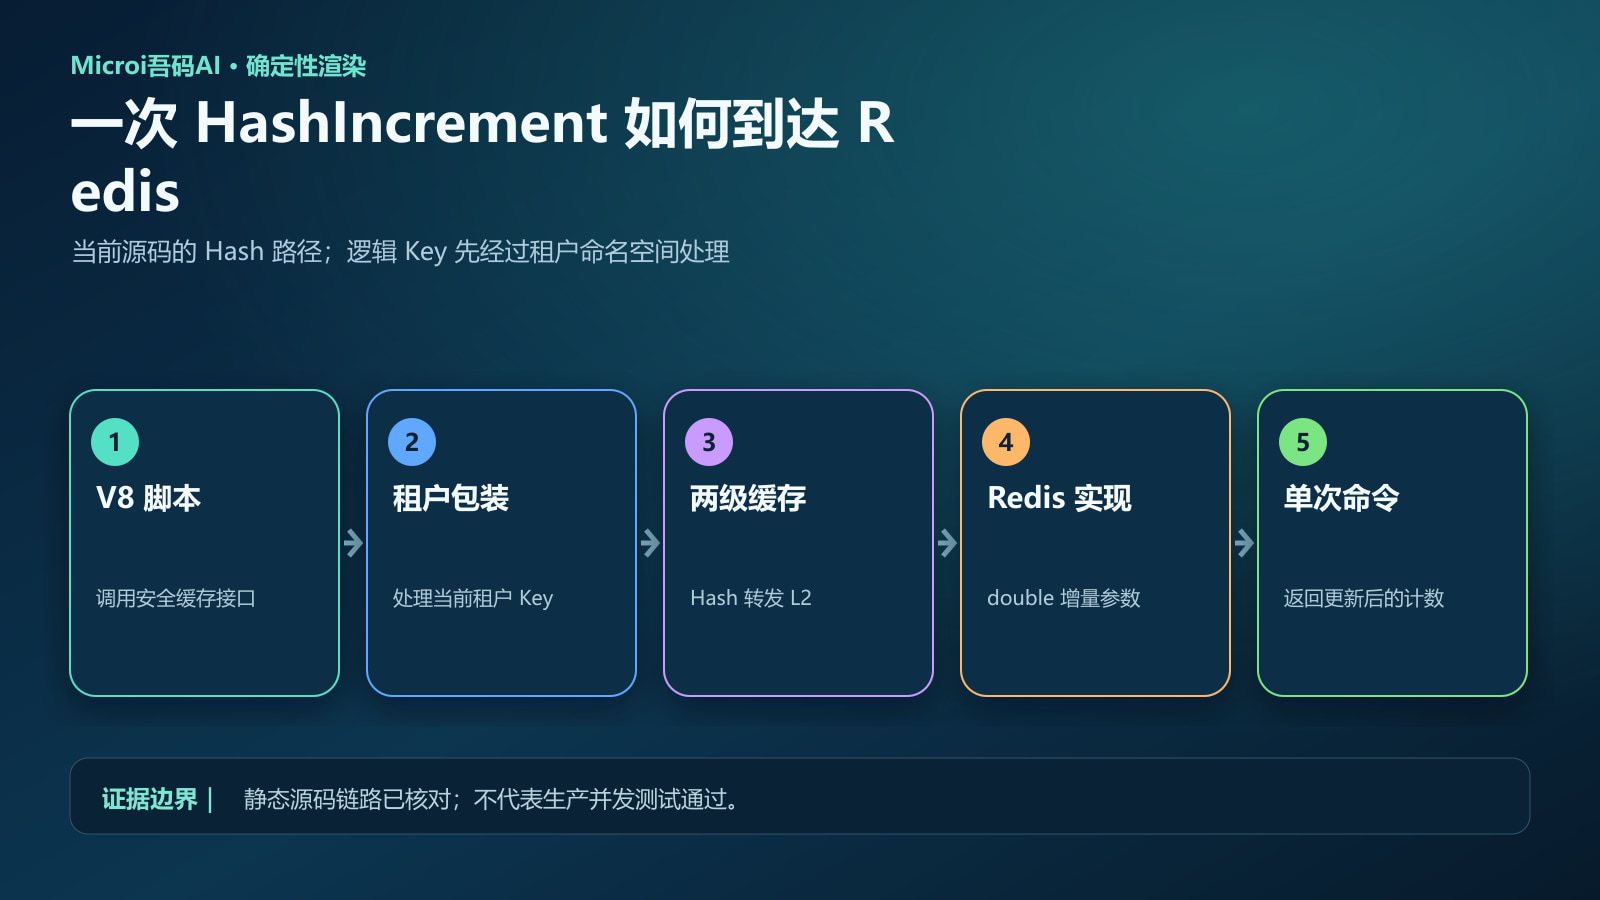
架构解释图(确定性渲染),依据当前源码绘制。
// 计数示例:逻辑 Key 由平台补上当前租户前缀
var attempts = V8.Cache.HashIncrement('Demo:Count', 'attempts', 1);
return { Code: 1, Data: { Attempts: attempts } };
这次加一由 Redis 在一次命令中完成。并发增量不再靠旧读数覆盖新结果。返回的新计数也有用:当上限为一时,根据本次返回值是否小于等于一判断,可以在这个简化计数模型中只让一个请求获得资格。
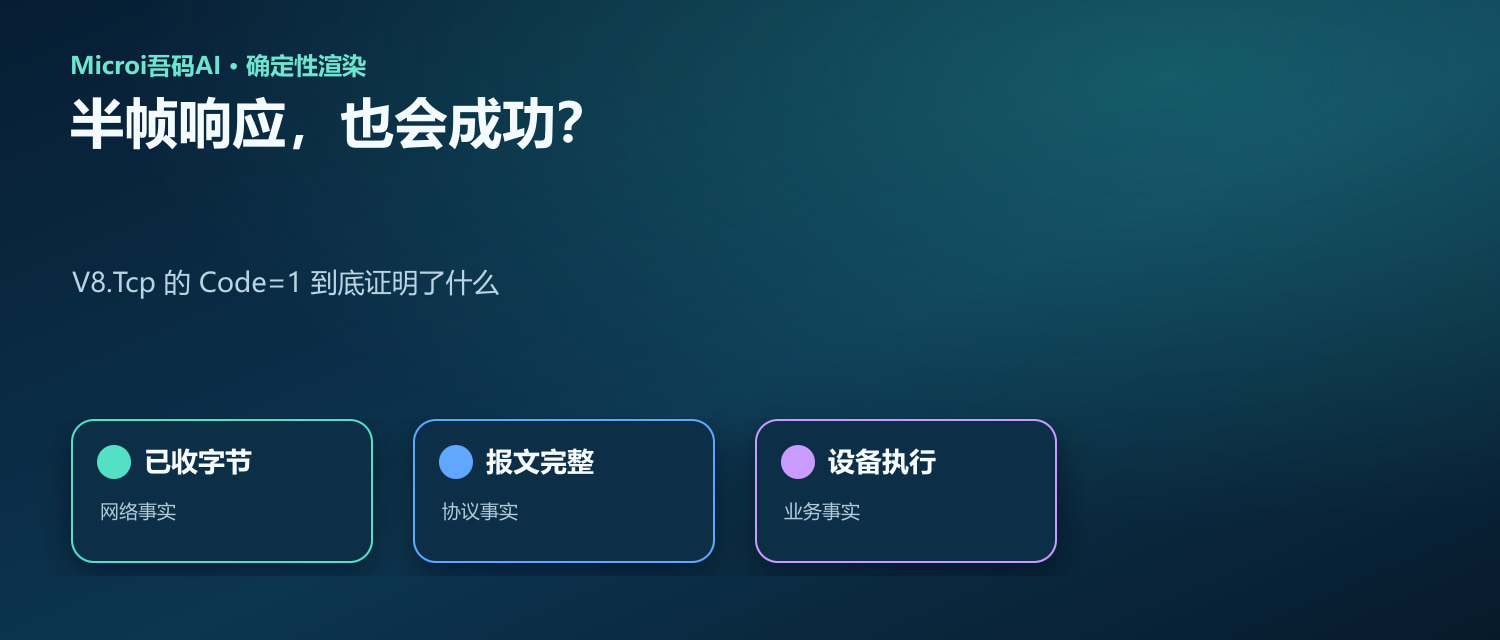
先定义计量单位| 这里统计的是尝试次数。后续业务失败也已经加过一;如果你想统计成功订单,计数点与恢复设计需要另行确定。
✦ 03|先比较,再加一,仍然会多放一个
一个容易遗漏的改法是保留原来的判断:先读次数,发现没有到上限,就执行业务,再调用原子加一。加一虽然正确,两个请求仍可能同时读到“还有名额”。问题从丢计数变成了准入判断竞争。
- 仅做监测:原子增量后记录返回值,不拦截业务。
- 做尝试次数限制:先获得原子增量返回值,再按明确的上限决定是否继续。
- 做库存或资金扣减:用业务数据库的约束、条件更新或事务承担最终正确性。
原子计数不能替你选择业务语义。即使每一次尝试都被准确记录,也不代表每一次业务动作都能安全执行。对重要副作用而言,Redis 的保护只能是外层策略,不能成为账务事实的唯一来源。
边界| “没有漏记请求”与“没有超卖、重复扣款”是不同承诺,需要不同证据。
✦ 04|窗口结束,比加一更容易被忘记
限流通常还有一句隐含条件:每分钟、每用户,或每个固定时间段。HashIncrement 本身没有窗口参数。当前 Expire 则是另一个调用,而且 TTL 作用于整个 Hash Key,并非某一个字段。
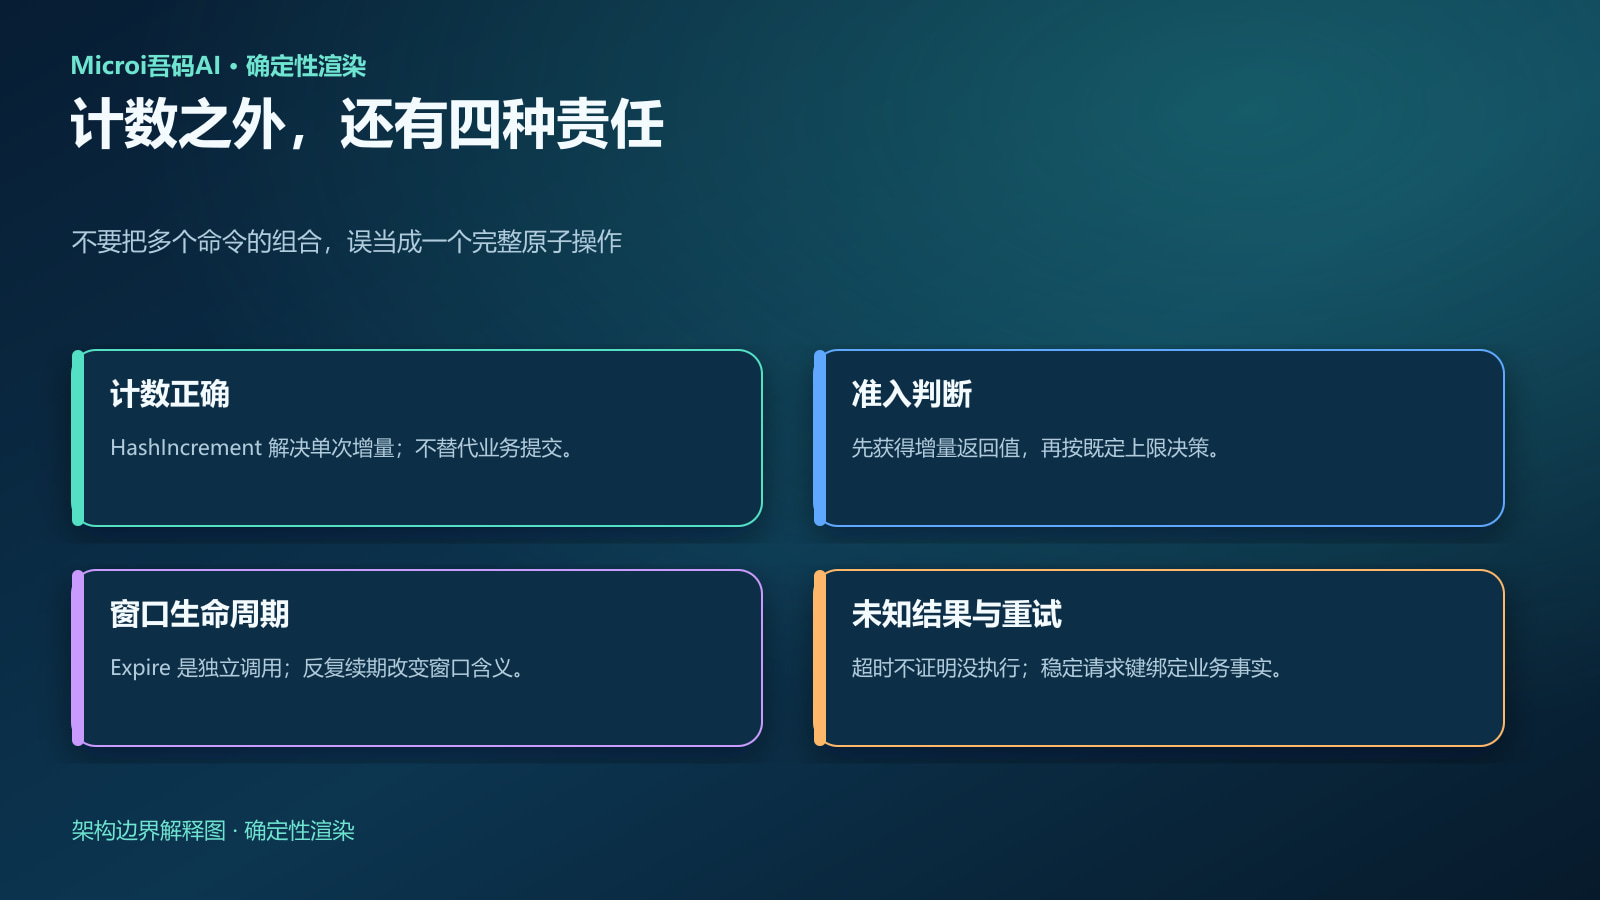
边界解释图(确定性渲染),不是生产运行截图。
// 演示 Hash 的整体过期范围,不是完整限流实现
V8.Cache.HashIncrement('Demo:Window', 'user-A', 1);
V8.Cache.HashIncrement('Demo:Window', 'user-B', 1);
V8.Cache.Expire('Demo:Window', 60);
如果每个请求都重新设置六十秒 TTL,这个 Key 的寿命会不断向后延长,含义接近空闲过期,不能直接称为固定一分钟窗口。如果仅第一次增量后设置 TTL,两个命令之间又存在进程退出的空隙。固定窗口还需要明确时间来源和清理策略;跨窗口边界的突发量也需要评估。
实现选择| 需要把窗口创建、增量和准入放在一个原子步骤时,应使用经过验证的专用限流能力;不要为方便而向普通 V8 暴露原始 Redis 连接或任意脚本执行。
✦ 05|一个可复现的交错模型
本次用 Python 枚举两个请求各自“读再写”的所有合法交错。总共六种顺序,其中四种最终只留下一个增量。再把每个增量视为不可分割操作,两个可能顺序的返回值都是一、二;按上限一判断,各只有一个请求通过。
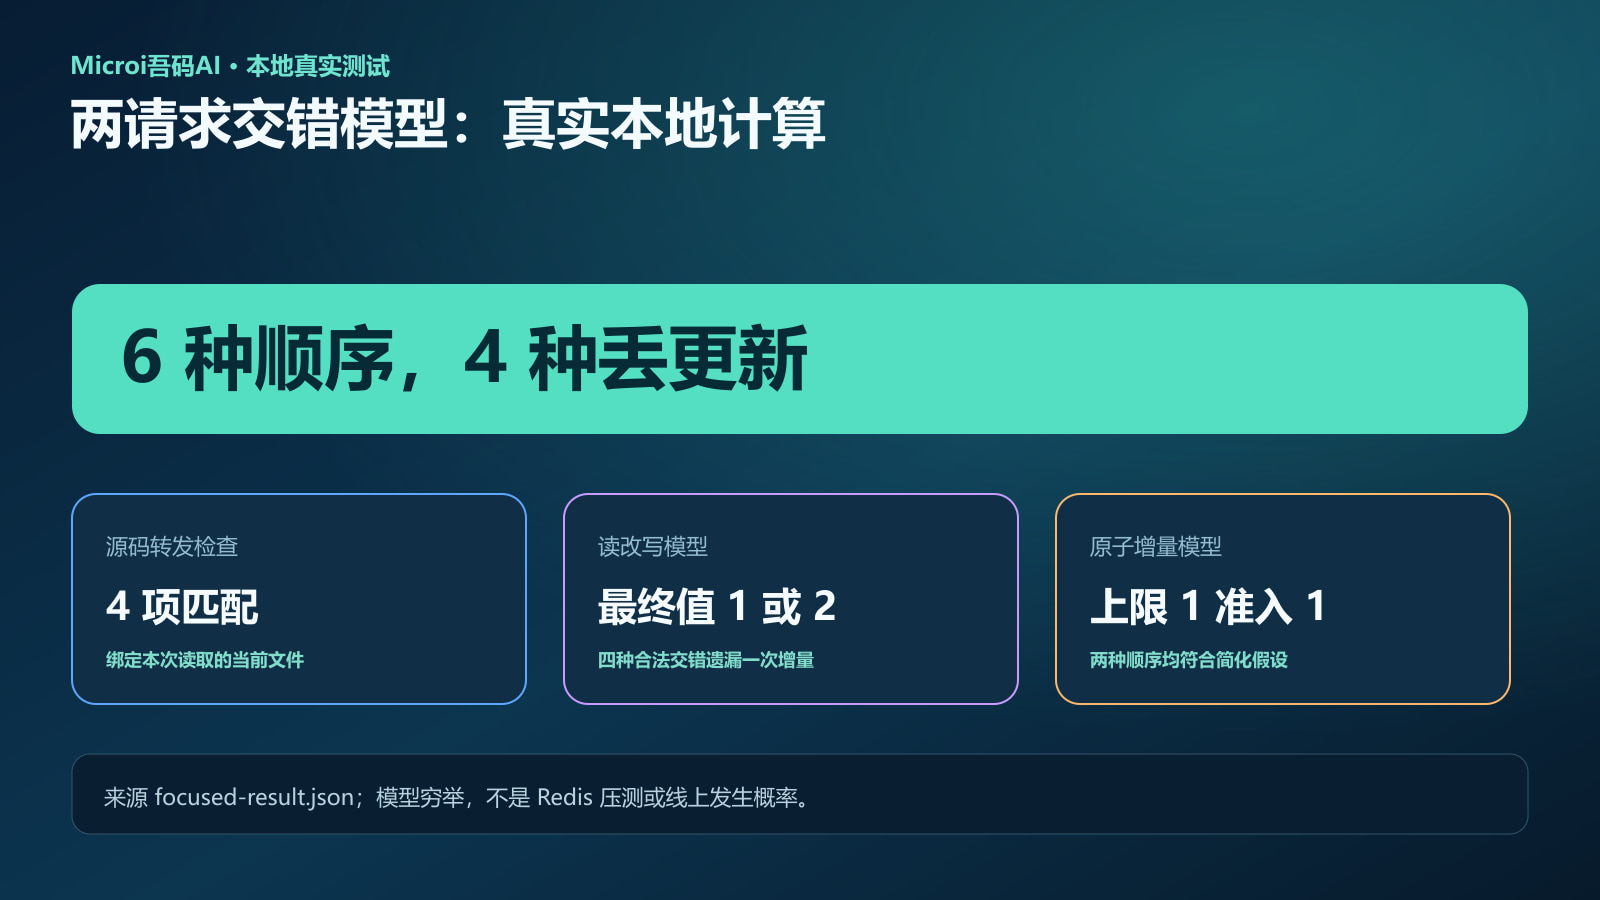
真实本地计算结果的确定性可视化;不是 Redis 压测或生产测试。
这个数字是模型的穷举结果,不是线上发生概率。它证明指定操作语义下存在丢更新,也展示原子增量能消除这类交错;没有测网络、Redis 故障转移、资源淘汰或多地域时钟。源码签名检查同时确认了租户包装、两级缓存和 Redis 的实际转发关系。
证据等级| 源码检查说明代码如何连接;交错模型说明一种竞争如何发生。它们都不能替代目标环境的并发与故障测试。
✦ 06|超时之后,重试可能再加一次
请求等待超时,只说明调用方没有及时得到结果。Redis 可能已经完成增量,响应却在返回途中丢失。直接重试会把同一个业务尝试再计一次。如果随后还创建订单,问题会继续扩大:相同业务请求可能进入第二次处理。
SetIfNotExists 带正数 TTL 可以提供短期去重入口,但它没有唯一持有者令牌、续租和仅持有者释放语义。它不是完整分布式锁。关键业务仍应绑定稳定请求标识,用数据库唯一约束或状态机决定副作用是否已经发生。
- 为一次业务尝试分配稳定请求标识,网络重试沿用它。
- 遇到未知结果先回读权威状态,再决定是否继续。
- 分别记录拒绝、超时、业务失败和最终成功,避免一张次数表承担所有含义。
✦ 07|把能力放回合适的层
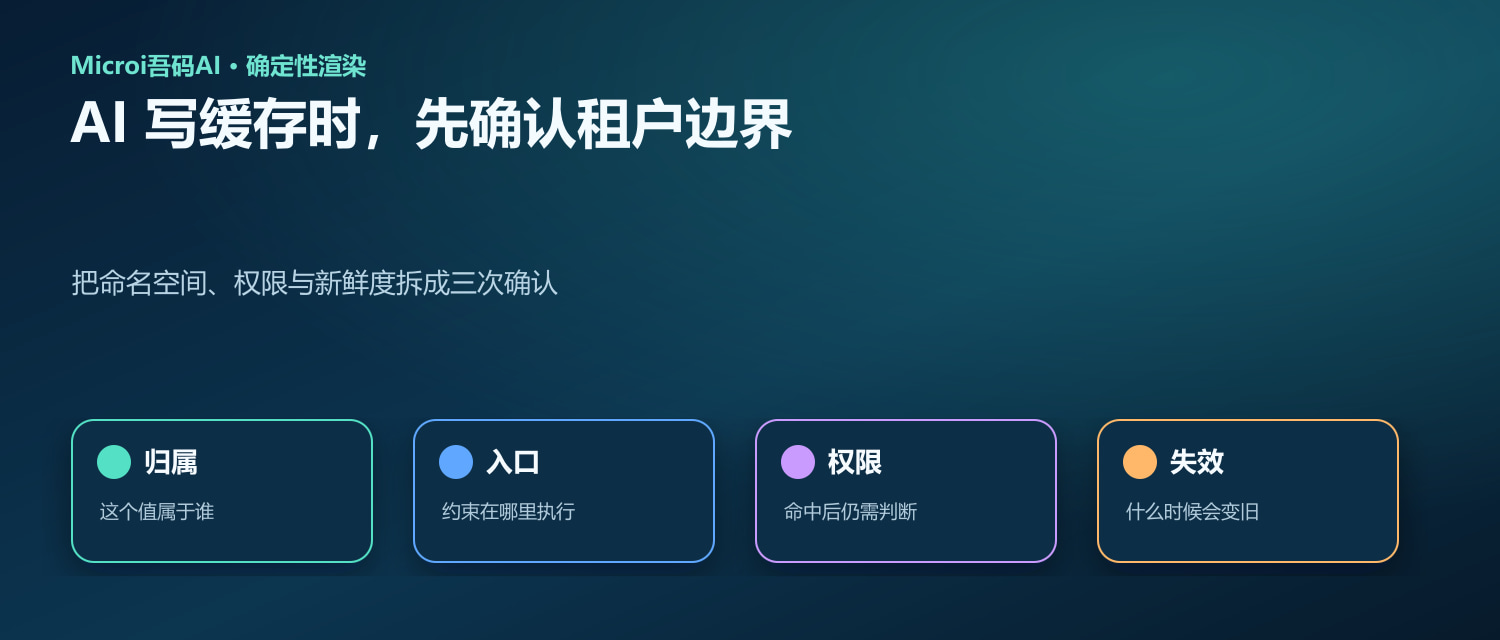
在 Microi吾码AI 中,接口引擎适合编排:识别当前用户,构造可信业务维度,调用现有安全原子,决定返回结果。租户命名空间、Redis 连接和底层原子操作由平台包装负责。不要让外部参数直接决定其它租户的 Key,也不要把一个无界用户输入变成无限增长的缓存字段集合。
上线前需要明确窗口算法、最大键数量、过期策略、失败时放行还是拒绝,以及告警阈值。再在真实部署中测试并发、超时与恢复。先把这些承诺写清楚,才知道你缺的是一个计数 API,还是一个带故障语义的限流组件。
结论| HashIncrement 能让一次增量不可分割;限流器还必须管理资格、窗口和失败。把这些责任拆清楚,简单 API 才不会背上它没有承诺的正确性。
本文由 AI 辅助原创撰写并结合当前源码与本地模型核验;竖版概念配图由 AI 生成,架构图和结果图采用确定性渲染。示例使用演示 Key,不构成已验收的生产限流实现。
本文由AI辅助原创撰写,概念配图由AI生成,架构与验证结果图为确定性渲染。

宁波官方开源宣传和活动阵地,欢迎各位和我们共建开源生态体系!
更多推荐
 0
 0
- 0


 已为社区贡献126条内容

所有评论(0)