星砂渡口:17秒AI短片里的一个配重
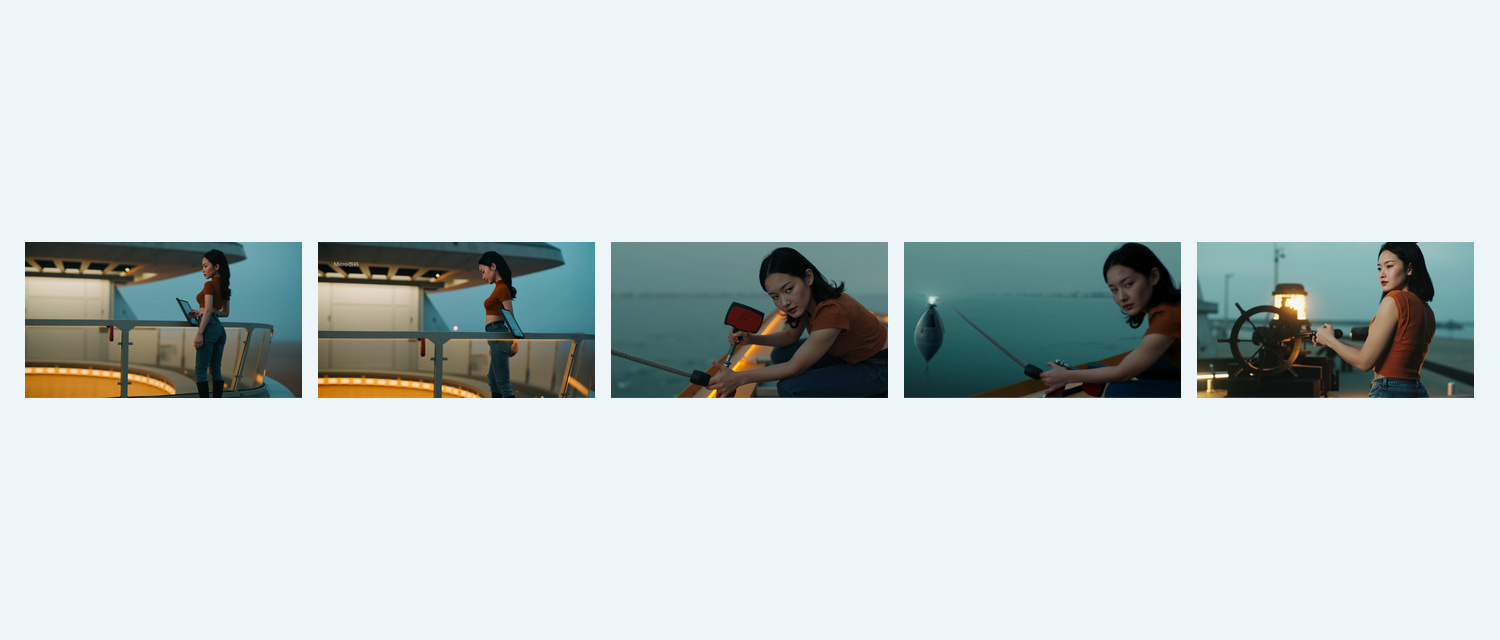
原创AI分镜与真实视频抽帧的确定性拼版
摘要| 星砂渡口的引力缆绳需要一次配重回摆才能接回漂流的旧信标。值守员把唯一的返航舱当作配重推下,信标回到泊位,她把闸门留给可能永远不会来的船。短片用三个镜头讲清这个交换,以及它留下的希望与代价。
✦ 01|先写代价,再写希望
一个只有奇观的科幻场景很容易拍成壁纸。这一次先写规则:星砂渡口的引力缆绳需要一次配重回摆,才能把漂流的旧信标拉回泊位;而唯一的配重,是渡口自己的返航舱。
规则一旦成立,选择就自己长出来:推下返航舱,她就没有自己的船;不推,信标永远漂在暗处。短片用三个镜头讲完这个交换,而不是用旁白解释它。
故事核心| 她可以用自己的返航舱换回一只信标,但换不回自己回家的那班船。
主角被明确写成一个虚构的22岁成年东亚女性:赤陶色的不透视合身短款上衣、蓝色低腰紧身牛仔裤、黑色齐肩中分长发。三镜头保持同一身份与服装,让注意力停在决定上。
✦ 02|第一镜:让信标先出现在画面里
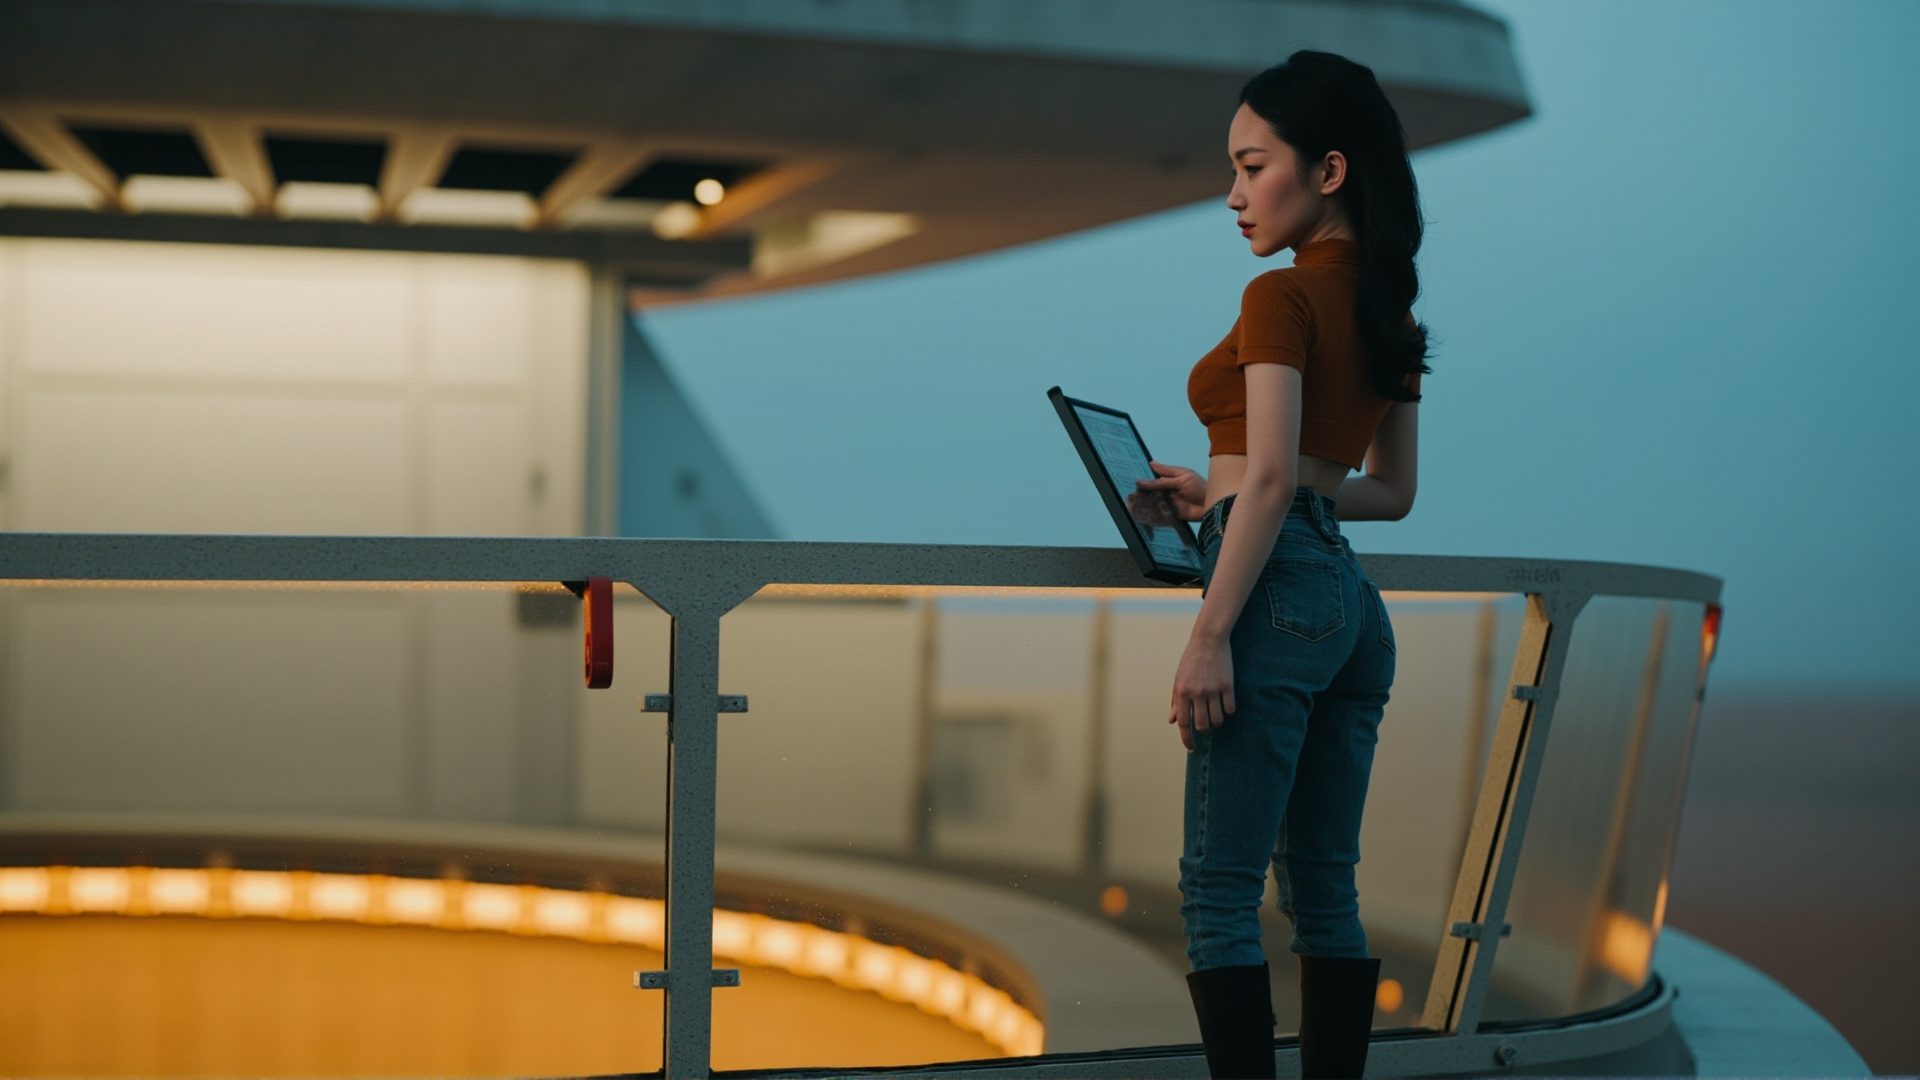
原创首帧01|平台、数据板与远处的信标
开场把人物放在玻璃栏杆旁:平台灯带沿弧形边缘亮起,冷青色夜空下,信标的光点在栏杆外漂移。她手里拿着数据板,刚刚从信标的方向转向平台内墙——那里装着落点拉杆。
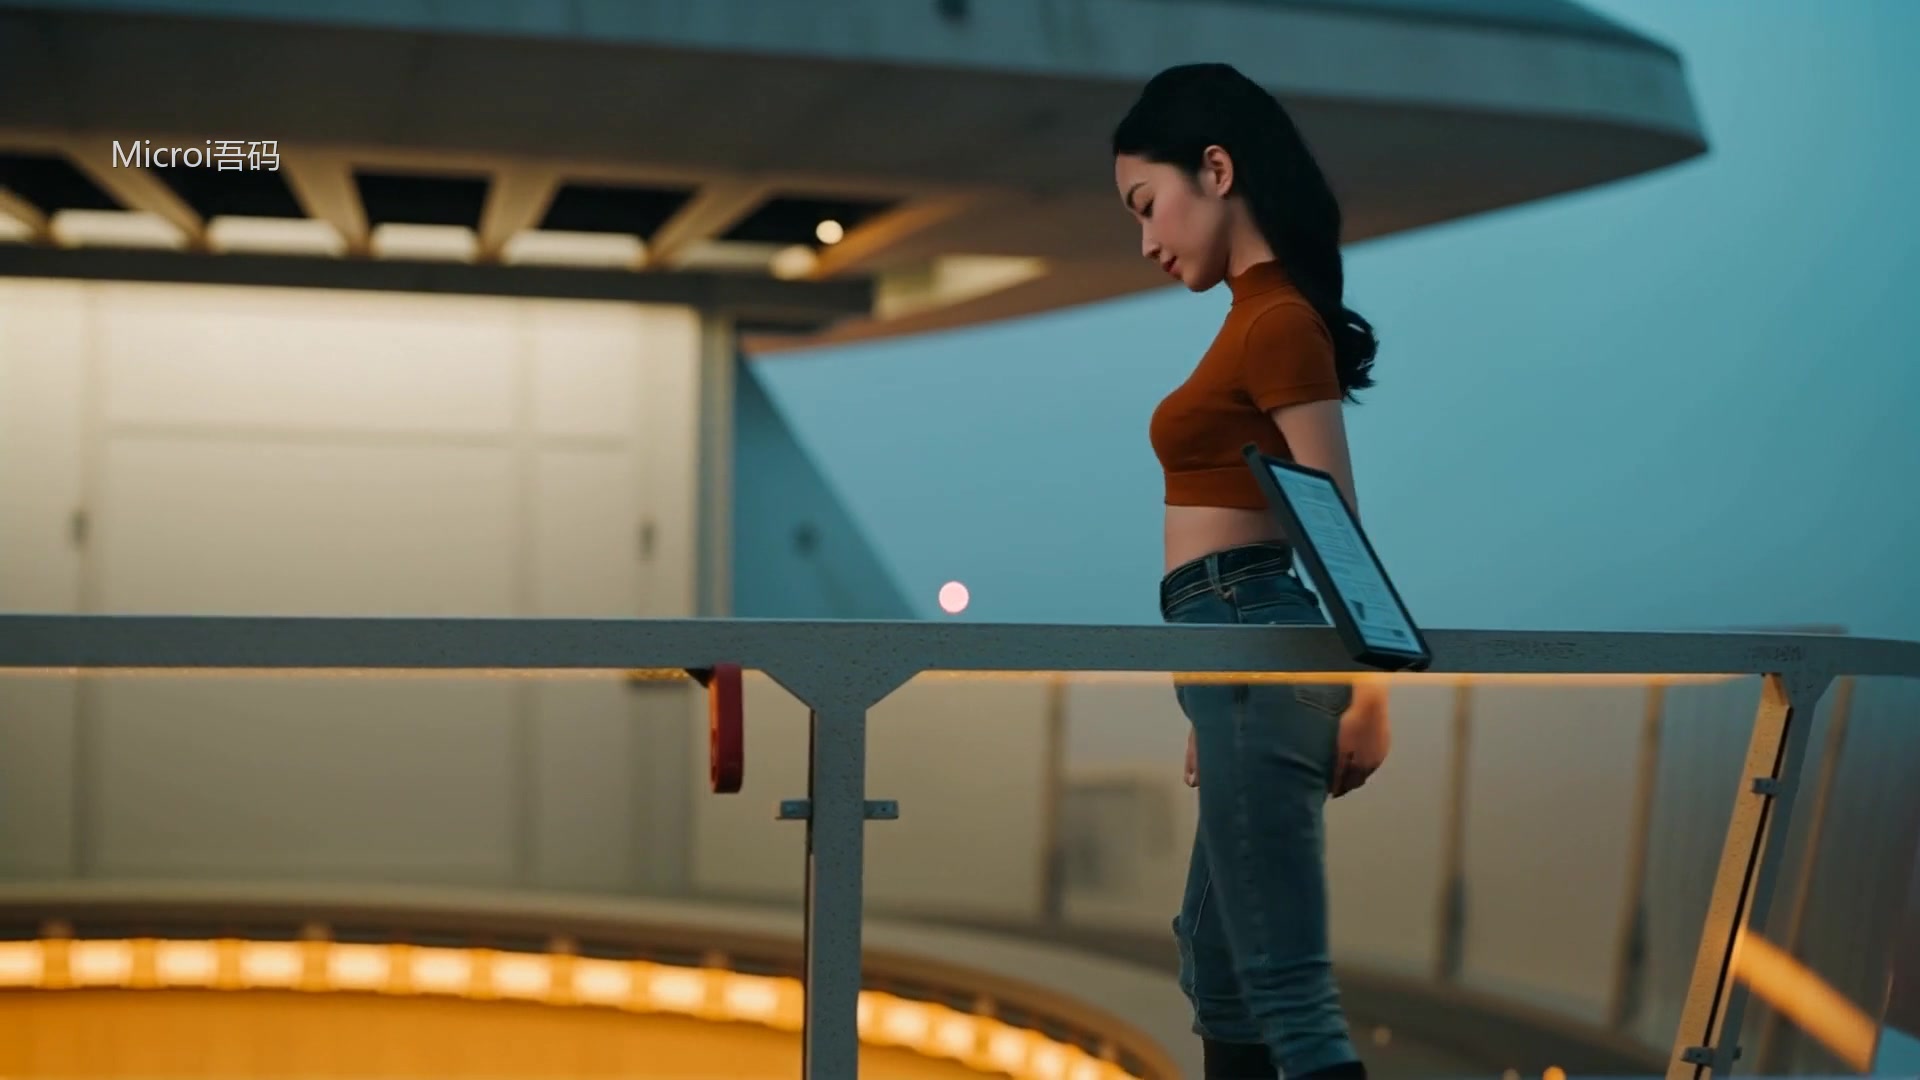
真实视频中段抽帧|转身、迈步、长发摆动
这一镜只保留一个主导动作:转身并迈步走向拉杆。长发摆动、沙尘漂移与灯带亮度变化同时发生——运动必须能被时间轴证明,单张原图做推拉不算视频。
镜头功能| 先把代价写进空间:信标在远处,拉杆在近处,她必须走过去。
生成前先写死一份面部与造型约定,再把选角肖像作为身份锚点交给首帧生成。首帧决定起点,动作提示词决定接下来发生什么。
✦ 03|第二镜:把动作变成因果
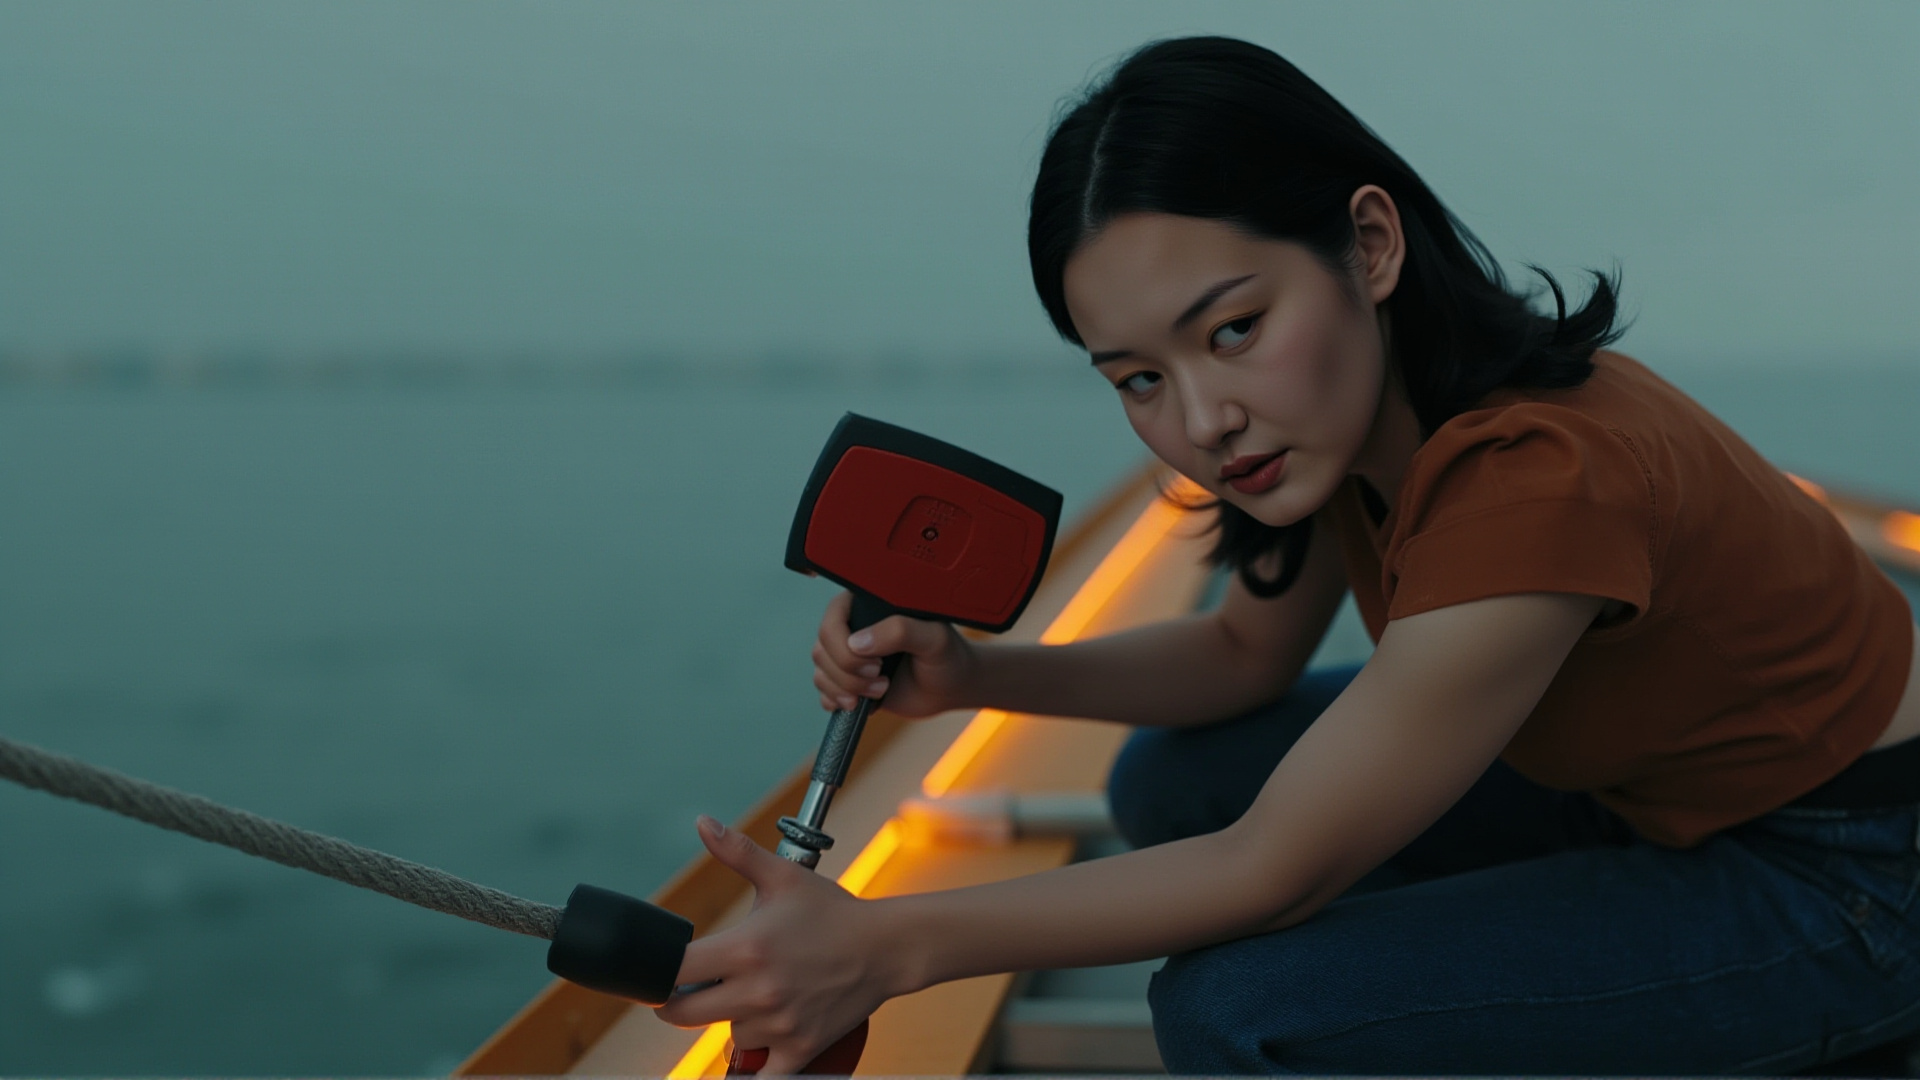
原创首帧02|红色拉杆、绷紧的缆绳与脱离的返航舱
第二镜只有一个动作:双手把红色拉杆推到底。随后缆绳绷紧,浮标与返航舱被拉出并摆动,漂流的信标开始沿弧线回摆——奇观不是装饰,它是动作的可见结果。
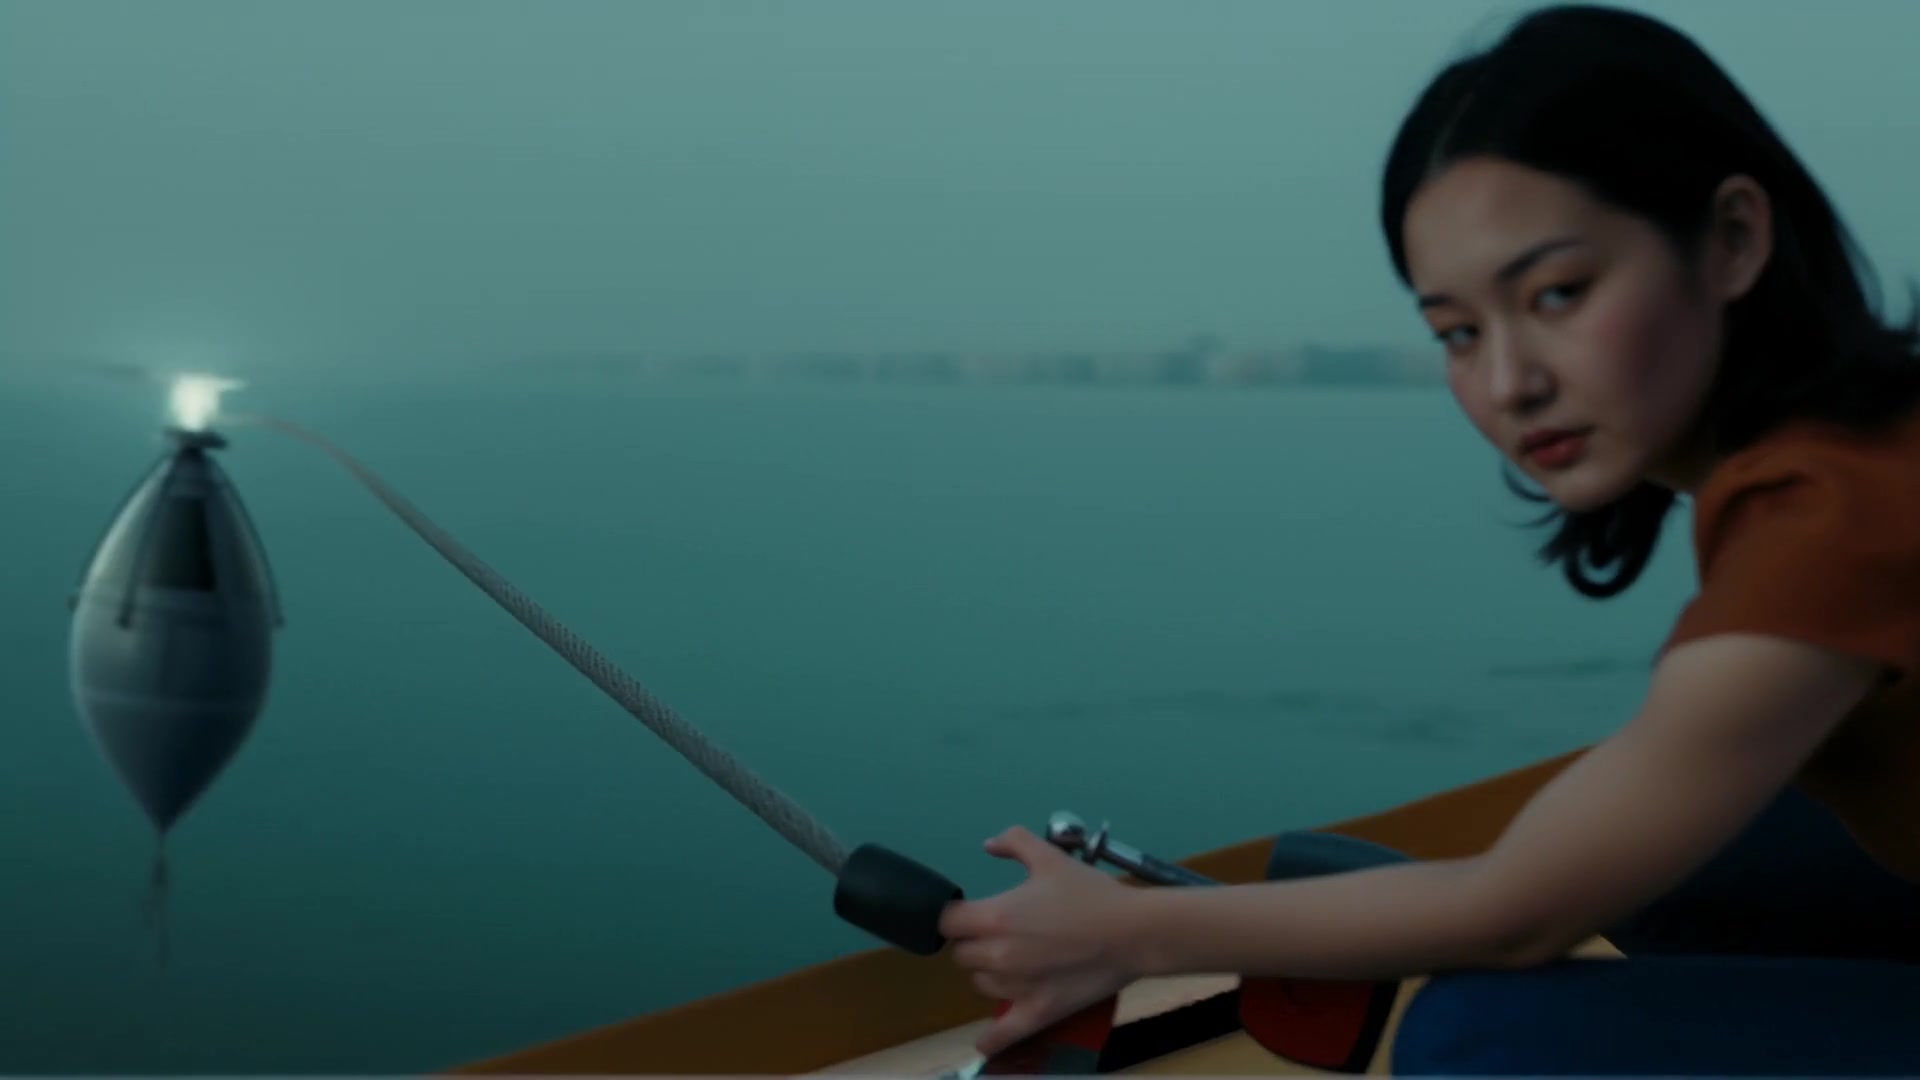
真实视频中段抽帧|缆绳绷紧、浮标外摆
因果链| 推下拉杆 → 返航舱脱离 → 缆绳绷紧 → 信标回摆 → 泊位等待接驳。
抽帧复核看三件事:手是否一直在拉杆上,缆绳与浮标的变化是否由她的动作引起,服装与发型是否连续。任何一项漂移,这一镜只重生该镜,不带病进入剪辑。
✦ 04|第三镜:把闸门留给下一艘船
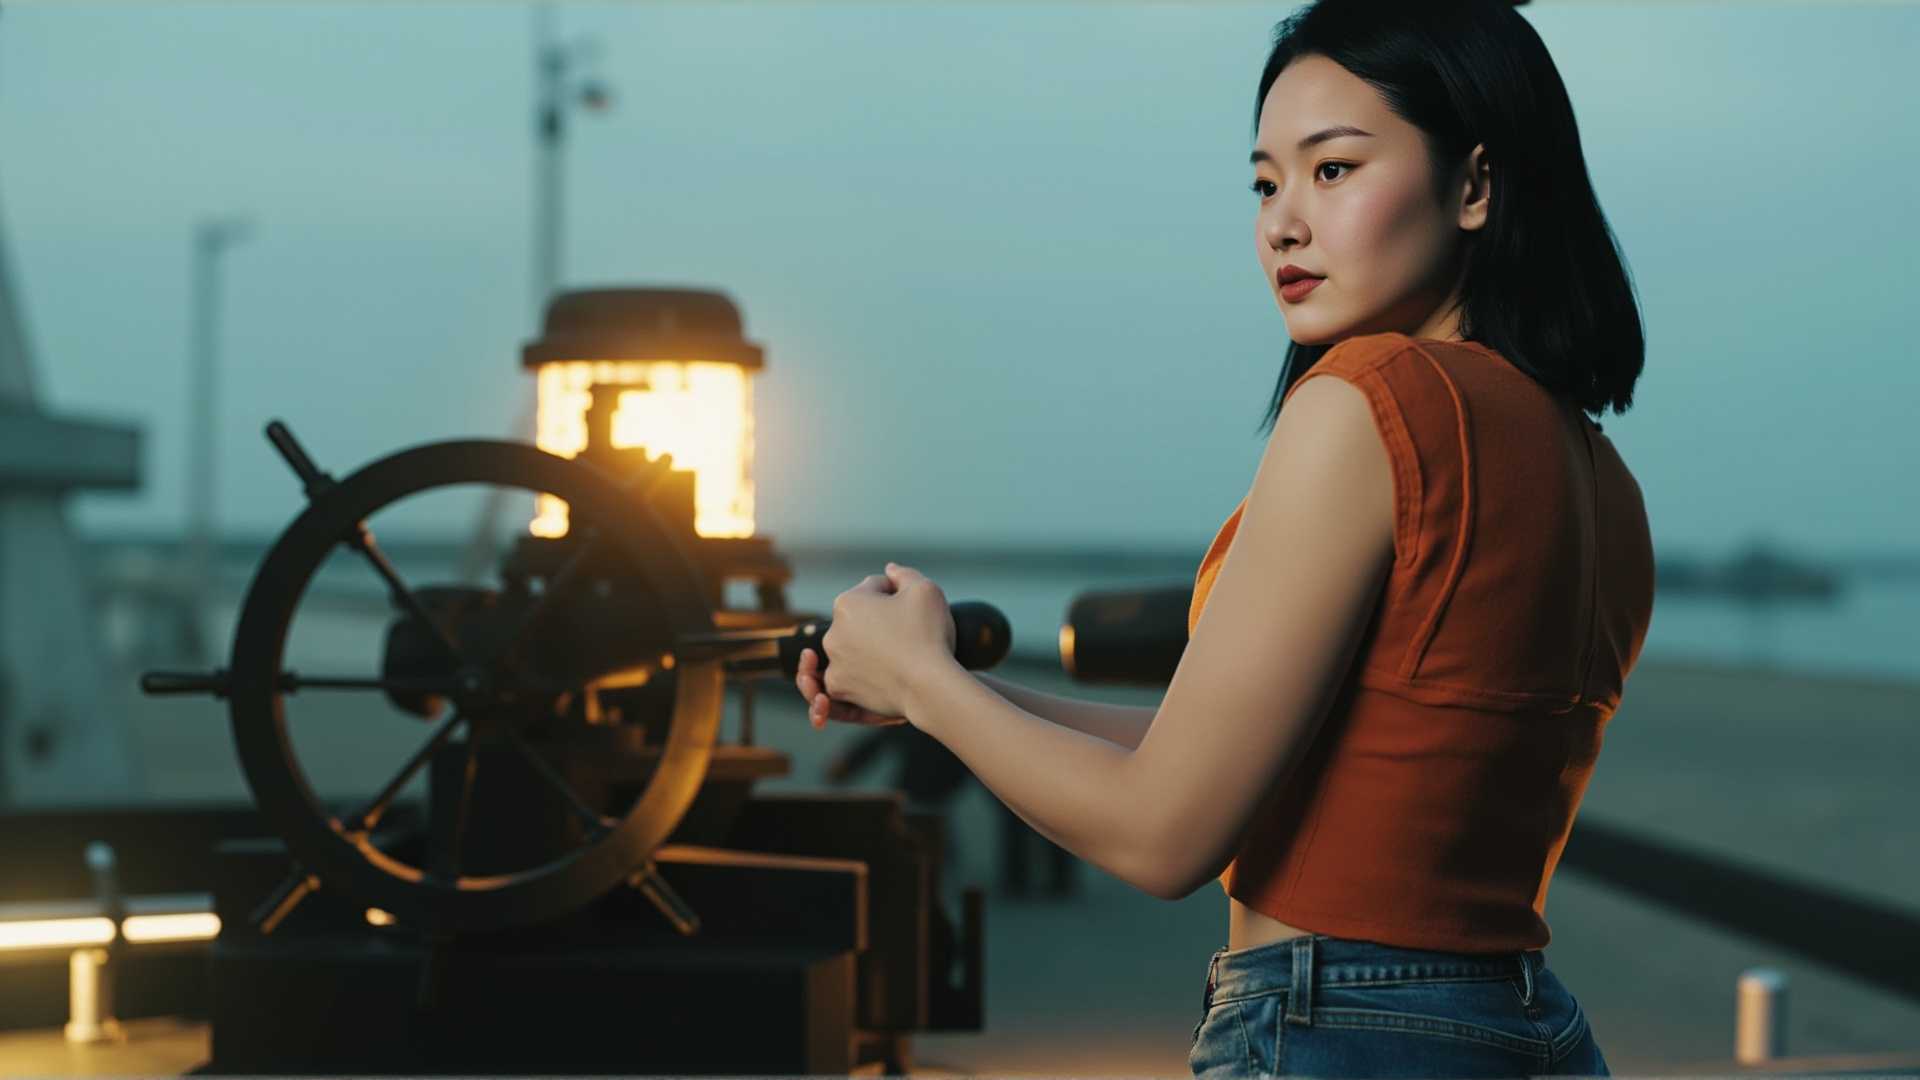
原创首帧03|泊位灯亮起,她在舵轮旁抬头
最后一镜不再增加事件。泊位灯由暗到亮,天空从暮色转向深蓝,她扶着舵轮抬头,露出一个很轻的笑。成功没有抹掉代价——返航舱已经漂远,她留在了渡口。
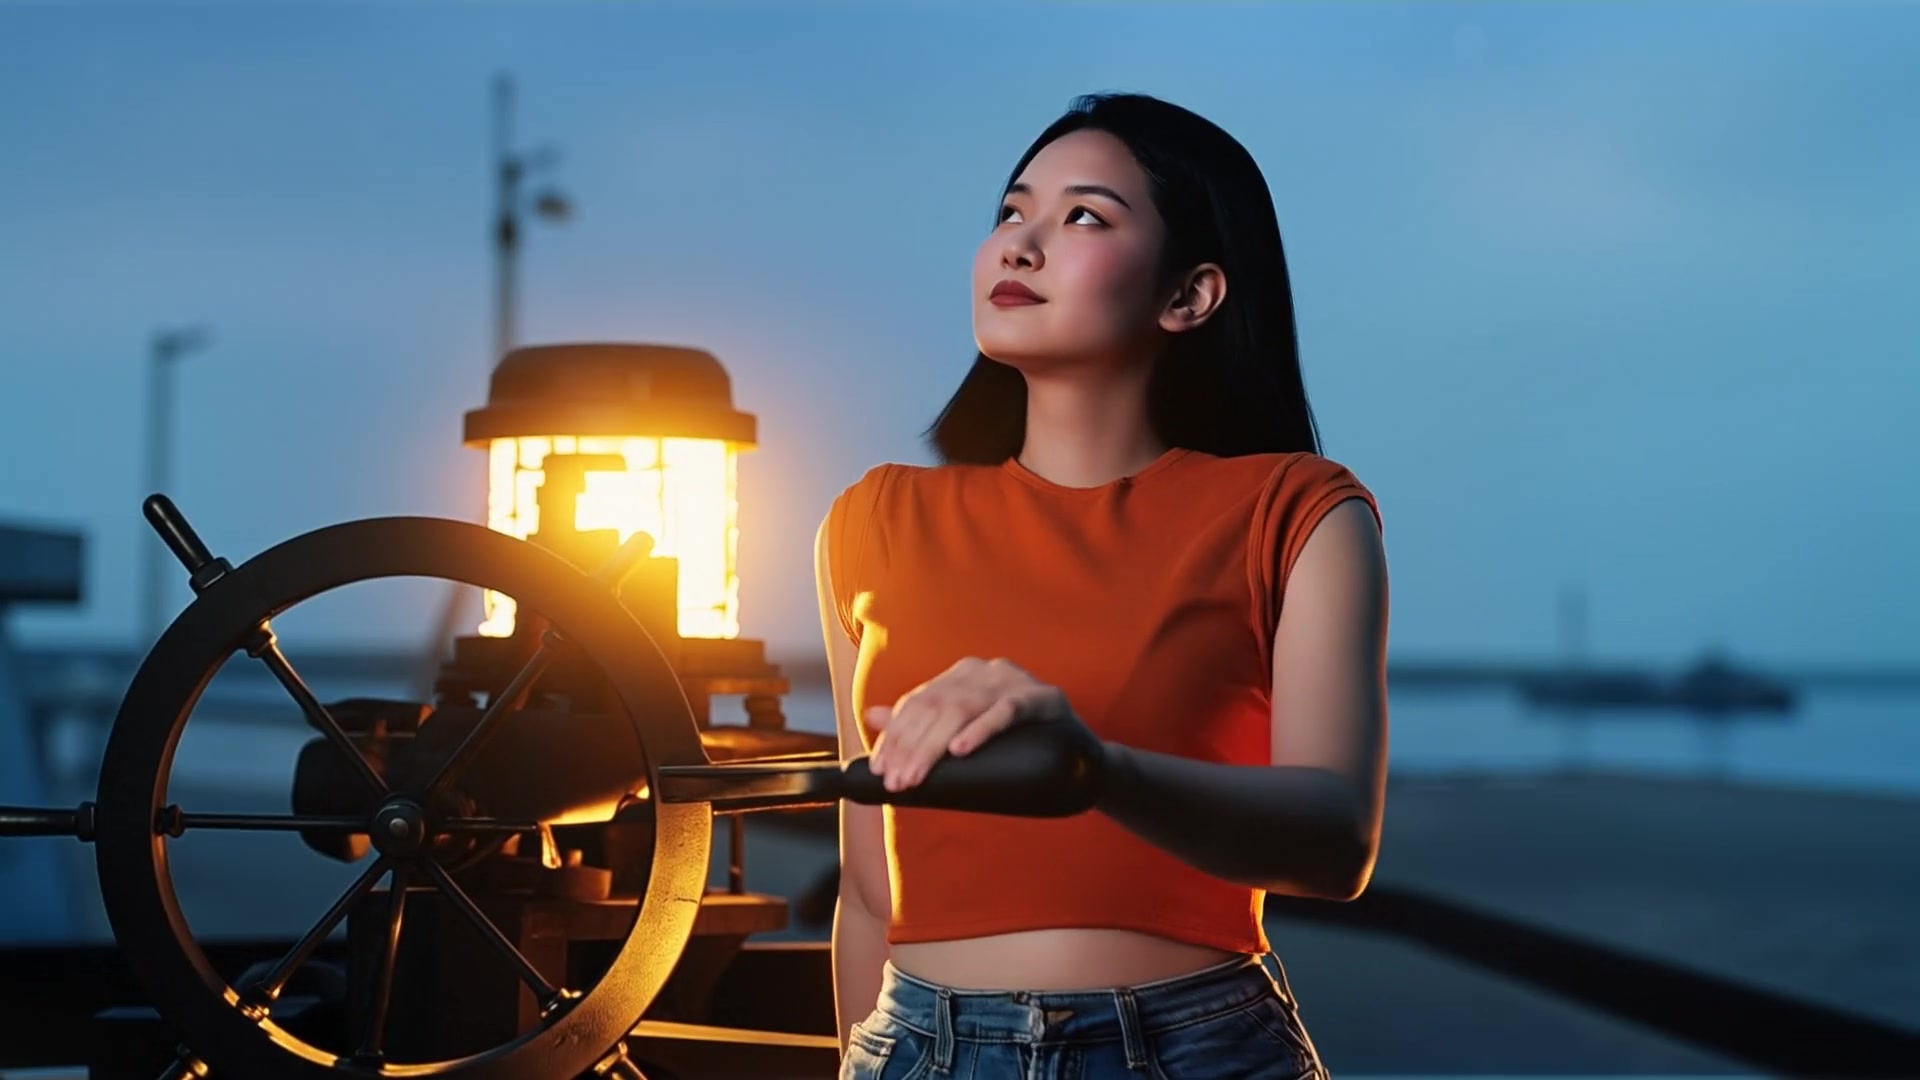
真实视频中段抽帧|灯亮、天空转蓝、微笑收束
收束| 泊位灯亮起,她把闸门留给可能永远不会来的船——希望与代价留在同一个画面里。
如果最后只剩「任务完成」的漂亮画面,十七秒就只是一段广告;保留漂远的返航舱和一次疲惫的笑,故事才有余韵。
✦ 05|同一个人与同一个世界怎么保持
生成短片最容易发生的事,是第三镜悄悄换了张脸。这次先写死十二项面部与造型约定:脸部轮廓、眼型与眼距、眉弓、鼻梁与鼻尖、唇形、下颌与面中、肤色底调与真实纹理、发际线与发型轮廓、妆面、静态神态、微笑方式、眼神高光。
- 选角:三位独立成年亚洲候选并排比较,一位因托腮遮挡下颌被淘汰、一位因右侧水印被淘汰,选中正面清晰的候选一。
- 首帧:以选角肖像为身份参考生成三张分镜首帧,服装统一为赤陶色短款上衣与蓝色低腰紧身牛仔裤。
- 复核:每镜抽取首、中、尾三帧,逐帧确认眼睛、五官、发型、妆面与美感不漂移。
- 标识:Microi吾码 以确定性静态合成小面积出现在第一镜的墙面标识位置,一次、准确、不靠模型凭空生成。
{
  "shots": [
    { "id": "01", "seconds": 5.875, "action": "转身走向拉杆", "camera": "缓慢推近" },
    { "id": "02", "seconds": 5.875, "action": "推下拉杆,缆绳拉出浮标", "camera": "缓慢横移" },
    { "id": "03", "seconds": 5.875, "action": "扶舵轮抬头微笑", "camera": "近乎静止的推近" }
  ]
}
✦ 06|声音:三句旁白与四段能量
旁白按镜头分句生成,三句分别落在前提、交换与结果三个位置;句与句之间留出呼吸。全长 17.625 秒,最后一句在第三镜开始时进入,收在希望与代价之间。
[
  { "start": 0.7,  "text": "星砂渡口的缆绳,只剩最后一次上弦。" },
  { "start": 6.3,  "text": "她把唯一的返航舱推下,换回那只漂流的信标。" },
  { "start": 11.9, "text": "泊位灯亮起,她把闸门留给可能永远不会来的船。" }
]
配乐按「建立—推进—高潮—余韵」四个节点改变能量:冷夜底噪铺底,拉杆动作加入脉冲,信标回摆时推到最高,最后一镜退后托住旁白;人声出现时配乐自动压低,转场击点对齐剪切点。
声音结构| 三句旁白 + 四段能量 + 环境、拟音与转场三层效果——声场按镜头组织,而不是按旋律铺满全片。
对白与旁白由受保护的生成式语音能力创建,声线、模型与情绪随回执留档;混音完成后单独验收响度、真峰值与削波,不把「能听见」当作通过。
✦ 07|交付边界:哪些已经验证,哪些还要回读
短片发出去之前,先把哪些事已经验证、哪些还没有,分开写清。
- 已验证:三段原生镜头均为 1920×1080、24fps、每段 5.875 秒,逐段抽帧确认存在真实时间运动。
- 已验证:三镜人物身份、服装与妆面连续,结尾镜头的美感不低于开场。
- 已留档:原创配乐、旁白回执、字幕时间轴与母版测量(-16.02 LUFS、真峰值 -3.81 dBTP、零削波)。
- 待回读:各平台视频任务的终态与公开页——提交成功不等于公开可见。
交付边界| 约17.6秒横屏母版:三个镜头、原创配乐、成年女声旁白与中文字幕;平台结果逐项回读。
把边界写清楚,比把成绩写漂亮更有用。下一次创作,仍然先写一个人愿意付出的代价,再让镜头、光线和声音围绕同一个决定工作。
本文图片与视频画面由AI生成,人物和故事均为虚构。

宁波官方开源宣传和活动阵地,欢迎各位和我们共建开源生态体系!
更多推荐
 3
 0
- 0


 已为社区贡献138条内容

所有评论(0)