同一个任务ID为什么会报冲突:把幂等键和参数指纹分开
架构解释图(确定性渲染)|一次调用的四段边界:连接、写入、有界读取与结束原因
摘要| 把设备回执当成“一次调用一条消息”,是后端直连 TCP 最常见的误判。默认 3 秒接收超时、64 KiB 有界读取和三种结束原因决定了:Code=1 只说明这次读写有结果,不说明字节完整。把结束原因写进业务分支,比换更大的超时更管用。
✦ 01|现场:回执只回来一半
设备接入最常见的写法,是在接口引擎里直接发一条指令,然后把返回值当回执用。打印机先回状态字节,隔一秒多再回明细字节。代码拿到第一批字节就解析,明细缺失,业务层只看到一句“格式不对”。
这类现场通常会被归因成设备不稳定或交换机丢包。真正的原因更朴素:上层代码把“一次调用返回了 Code=1”读成了“回执已经收全”。
先给结论| TCP 是字节流,不是消息队列。一次调用、一次写入、一次读取各自有边界,三者并不重合。
下面按当前 Microi吾码AI 的 V8.Tcp 实现拆这件事:参数在哪儿被拦、读取循环只有哪三个出口、结束原因怎么进业务分支,以及为什么扩大超时并不能替代协议层的边界判断。
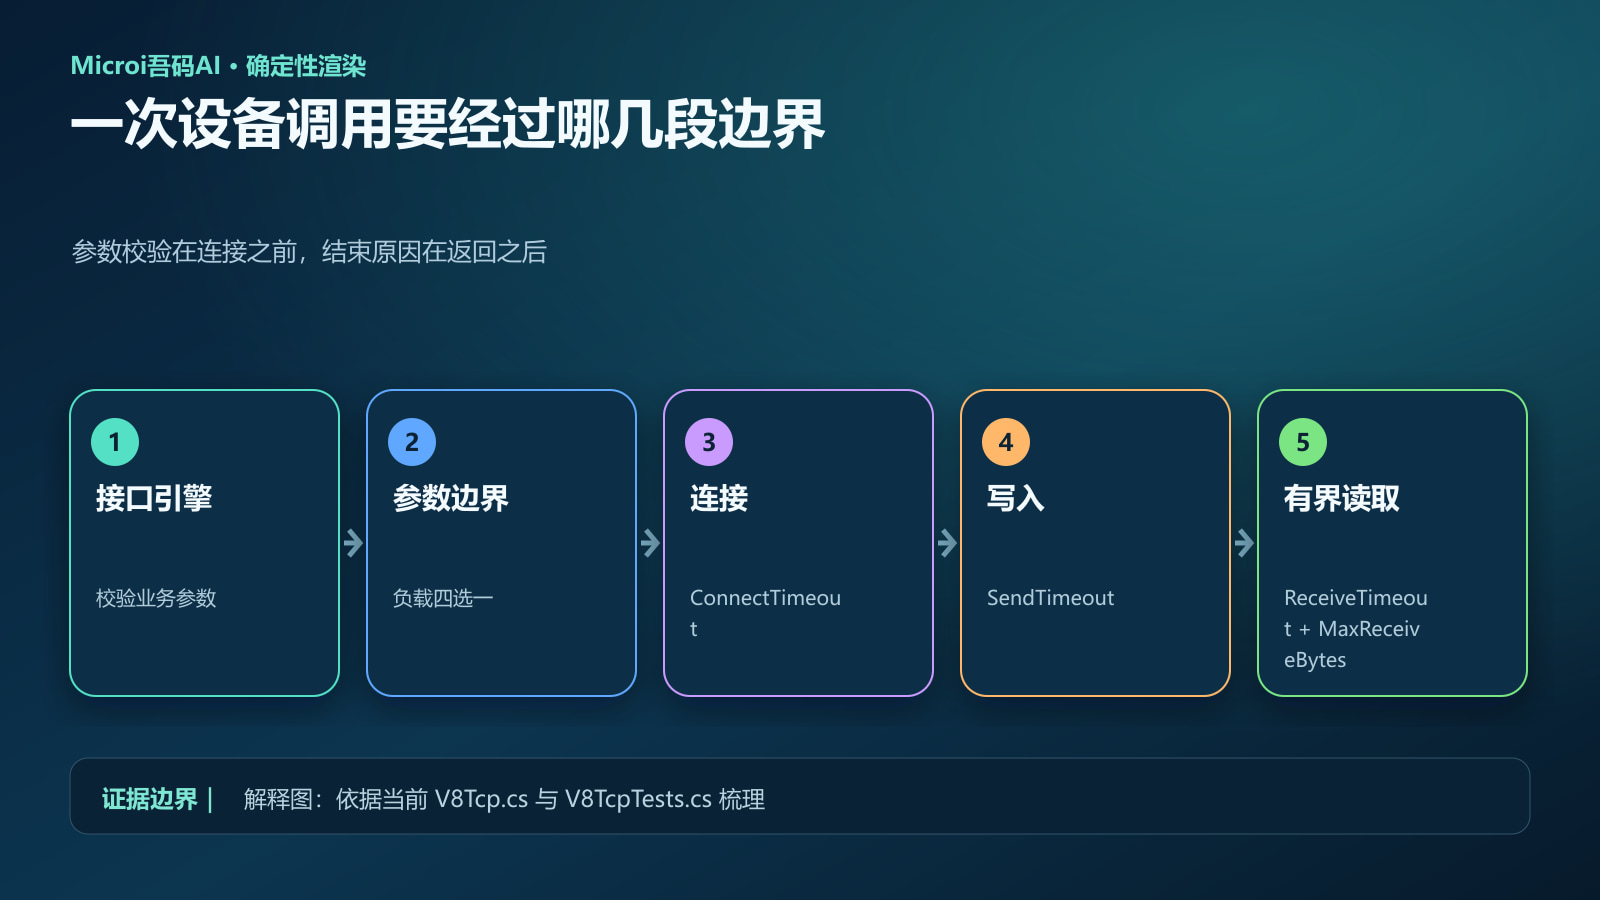
架构解释图(确定性渲染)|接口引擎 → 参数校验 → 连接 → 写入 → 有界读取 → 结束原因
✦ 02|直觉方案为什么不够:一次调用不等于一条消息
把 TCP 当消息通道的写法有三种常见变体:按行切割、按固定长度读取、读一次就解析。前两种其实是正确方向,只是必须由业务协议定义边界;第三种没有定义边界,只能靠运气。
还有一个容易被忽略的变量:Nagle 算法会把小包合并。当前实现里 NoDelay 默认开启,意味着小指令会立刻发出,但报文到达接收端以后仍然可能被合并或拆分。发送侧关掉 Nagle 并不能改变接收侧的字节流语义。
- 写入语义:Write 完成只代表字节进入本机内核缓冲,对端是否收到、是否执行是两件不同的事。
- 读取语义:一次读取可能只拿到半个响应,也可能一次拿到两条响应,取决于到达时机。
- 边界语义:行分隔、长度前缀、结束标记都属于业务协议,需要业务代码自己判断。
因此真正要问的不是“超时多大合适”,而是“这一次读取是在什么条件下的结束”。当前实现把这件事显式地写进了返回体。
✦ 03|调用链:四段边界与四个互斥负载字段
从接口引擎调用 V8.Tcp 时,参数校验发生在建立连接之前。Host 会被规范化和校验,Port 必须在 1 到 65535 之间,连接、写入与接收三段超时各自独立,范围都是 1 到 120 秒。
负载字段有四个互斥来源:Bytes 字节数组、ByteBase64、Hex 文本与 Text 文本。只能给其中一个,空负载会被拒绝,超过 4 MiB 的负载在连接前就被拦下。把上层请求对象直接透传进去,很容易同时带上多个字段,然后收到一句参数错误。
// 接口引擎:一次写入 + 有界读取,参数各自显式声明
var result = V8.Tcp.SendAndReceive({
    Host: '192.168.1.88',
    Port: 9100,
    Bytes: [27, 64, 29, 86, 0],   // 只能保留一个负载字段
    ConnectTimeout: 5,
    SendTimeout: 5,
    ReceiveTimeout: 3,
    MaxReceiveBytes: 4096
});
边界一| Host、Port 与负载来源先校验:字段互斥、空负载与超过 4 MiB 的负载都不会打开连接。
架构解释图(确定性渲染)|RemoteClosed / Timeout / MaxReceiveBytes 三种结束原因对应的业务动作
✦ 04|源码事实:读取循环只有三个出口
有界读取的实现很短:循环读取直到达到上限,出口只有三个。读到 0 字节表示对端关闭连接,结束原因是 RemoteClosed;读取超时且已经拿到部分字节时结束原因是 Timeout;达到 MaxReceiveBytes 时结束原因是 MaxReceiveBytes,并且 Truncated 为 true。
关键在第一种超时:如果超时时一个字节都没收到,实现直接返回失败;但如果已经收到一部分,它返回成功并把结束原因标成 Timeout。也就是说,Code=1 与“回执完整”没有必然关系。
- RemoteClosed:对端主动关闭,可以按协议解析完整报文。
- Timeout:已收到部分字节,必须按协议判断是继续补读还是判定失败。
- MaxReceiveBytes:达到本次读取上限被截断,需要提高上限或改为分段协议。
// 按结束原因分流,而不是只看 Code
if (result.Code !== 1) return { Msg: 'TCP 调用失败:' + result.Msg };
var data = result.Data;
switch (data.ReceiveEndReason) {
    case 'RemoteClosed':
        return { Code: 1, Data: { Hex: data.Hex } };
    case 'Timeout':
        return { Code: 0, Msg: '回执未收全,收到 ' + data.BytesReceived + ' 字节' };
    default: // MaxReceiveBytes
        return { Code: 0, Msg: '回执被截断,请提高 MaxReceiveBytes 或改用长度前缀协议' };
}
✦ 05|聚焦验证:仓库里的八个 TCP 用例
行为不靠推断。当前测试文件覆盖了参数互斥、负载上限、GB18030 文本、部分字节超时与截断标记:本地跑一遍过滤测试,8 个用例全部通过,用时 2 秒。
其中两个用例直接对应本文的两条结论:接收超时返回部分字节且结束原因是 Timeout;达到上限时 Truncated 为 true。另一条容易被忽略的用例是 GB18030:给中文小票机发文本时必须显式指定编码,否则设备按错误编码打印。
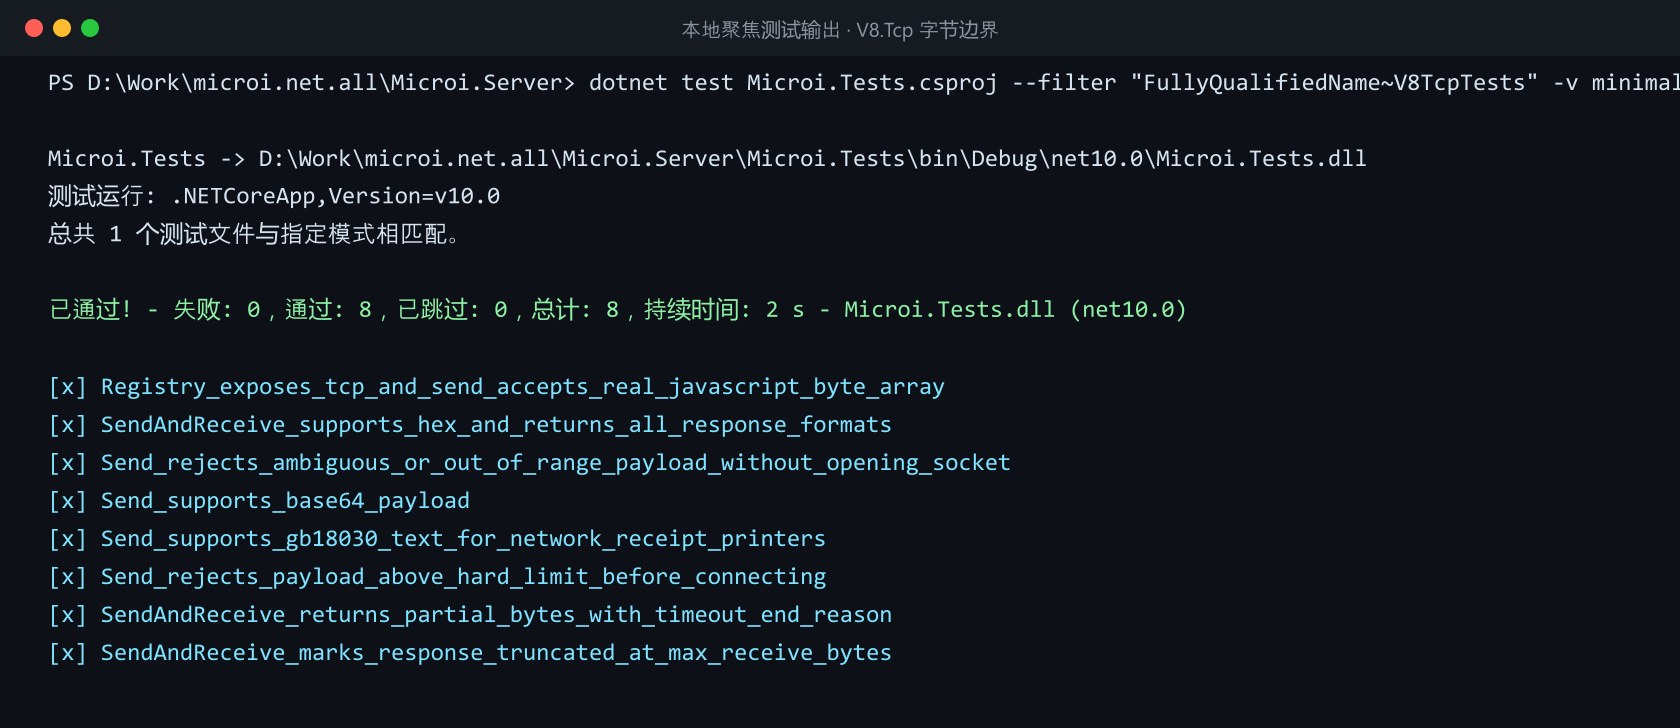
本地验证输出(确定性渲染)|dotnet test 过滤 V8TcpTests:通过 8、失败 0、用时 2 秒
证据边界| 本地测试通过只证明当前源码的读取与校验语义;设备真实行为、固件差异与网络抖动仍属于线上未验证部分。
✦ 06|失败与恢复:编码、超时与幂等重试
把结束原因接进业务分支之后,剩下三类问题需要按业务兜底。第一类是编码:中文小票机用 GB18030,其它设备可能是 ASCII 或 UTF-8,编码错了不会报错,只会打印乱码。
第二类是超时组合:连接、写入、接收三段各自 1 到 120 秒,默认分别是 10 秒、10 秒和 3 秒。接收超时给得太小会把慢设备判成失败,给得太大则会让接口引擎长时间占住请求。
还有一个容易踩的细节:接收超时的默认值是 3 秒,比连接和写入的 10 秒都短。慢设备在 3 秒内只回了状态字节时,业务会拿到一个成功调用加一段不完整回执。把 ReceiveTimeout 调大只能降低概率,真正的解法仍然是按结束原因分支,并让协议本身带上长度或结束标记。
第三类是重试:一次 Send 成功只代表写入完成,设备是否执行并不确定。盲目重试可能让打印机出两张小票。稳定幂等键加唯一约束,是避免“重试变重复”的唯一可靠做法。
- 写入完成但结果未知时,先按业务幂等键查询设备或中间表,再决定是否重发。
- 同一连接无法跨调用续读,需要续读时要把已收字节、已收长度写进业务状态。
- 设备协议若没有长度前缀或结束标记,应先在设备网关层补齐边界,再进入业务表。
✦ 07|生产取舍:什么时候不要在后端直连设备
直连 TCP 适合少量、低频、语义简单的设备调用,例如打印一张小票、读一次电子秤。设备数量上去以后,后端直连会遇到三个结构性限制:连接不可复用、读取必须有界、结果不可确定。
更稳的结构是把设备网关放在业务和硬件之间:网关维护长连接、按协议切分消息、把结果写回业务表;接口引擎只做校验、入队和查询。这样后端不再需要猜字节边界,重试也变成对任务的一次幂等重放。
取舍| 少数设备、明确协议:V8.Tcp 直连更省事;设备多、协议杂、要求可追溯:把边界判断下沉到设备网关,业务侧只处理幂等任务。
无论走哪条路,结论都一样:把结束原因、截断标记和写入完成度当成业务事实记录,而不是把 Code=1 当成整件事成功。这样设备接入的偶发问题才会变成可复现、可定位的工程问题。
文中封面与解释图由确定性渲染生成,卡片底图由AI生成;测试结论来自当前工作区实跑的过滤测试。

宁波官方开源宣传和活动阵地,欢迎各位和我们共建开源生态体系!
更多推荐
 1
 0
- 0


 已为社区贡献148条内容

所有评论(0)