先检索表结构,再让AI回答:一次Schema召回的拆解
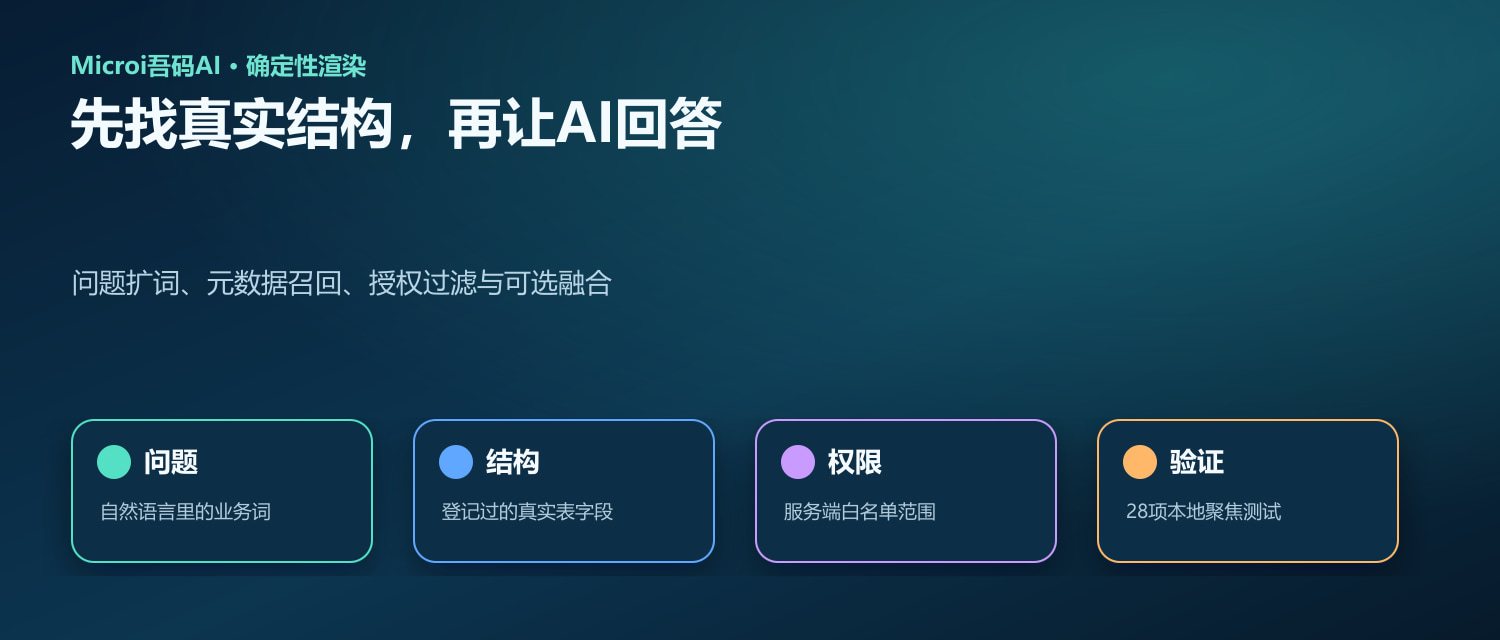
确定性排版的信息图;具体行为来自当前源码与测试。
摘要| 一句“哪些客户很久没有联系”,怎样找到客户表与联系时间字段?我们沿Microi吾码当前源码,把问题扩词、元数据索引、关键词排序、服务端白名单和可选向量融合拆开看,并核对28项聚焦测试。
✦ 01|问题里通常没有表名
业务人员问“哪些客户很久没有联系”,不会主动说出数据库里的英文表名。模型如果只凭语言习惯猜字段,可能把“创建时间”当作“最后联系时间”,得到看似合理、实际答非所问的结果。
Microi吾码的这条路径,先从当前租户登记的表单、字段和菜单元数据召回候选。它解决的是“该让模型看哪些结构”,随后才谈生成查询与业务回答。
本次观察点| 检索的对象是已登记、可解释、受授权约束的Schema;不是让模型遍历一切物理表后自由编造字段。
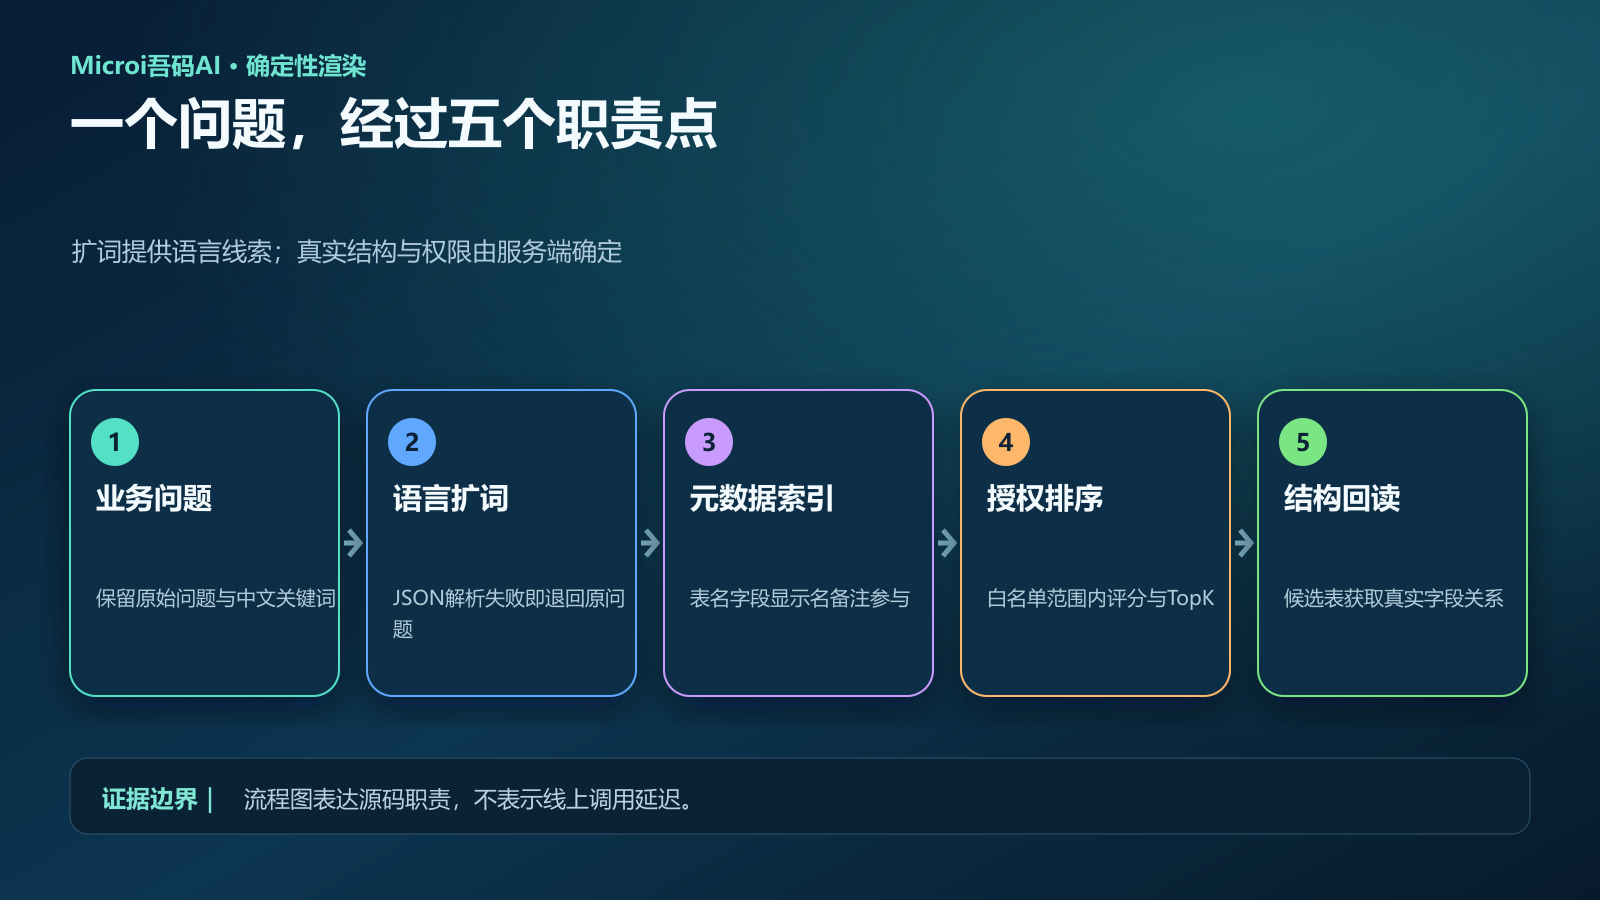
流程图由当前调用链抽象而成,表示职责次序,不是线上调用耗时。
✦ 02|扩词模型负责语言,不负责发明结构
AiSchemaKeywordExpansionService要求模型返回Keywords、BusinessEntities和Metrics。解析器还兼容TableKeywords与FieldKeywords,合并时忽略大小写去重,并限制每个词的长度与词数。
例如“很久没有联系”可以被扩展为联系、跟进、客户等候选词。但这些只是检索线索;模型输出的名词不自动成为真实表字段。实际标识仍要通过元数据检索和回读获得。
{
  "Keywords": ["联系", "跟进"],
  "BusinessEntities": ["客户"],
  "Metrics": ["联系时间"]
}
示意与事实| 上面的JSON用于解释扩词协议,是本文构造的例子。它没有冒充一次真实模型调用,也没有宣称这些字段在任一客户业务库中必然存在。
模型超时、异常或输出无法解析时,这一步保留原始问题并退回确定性关键词。中文二字、三字切片帮助“客户跟进记录”这类连续文字参与匹配,扩词失败不会自动把结构检索变成空白。
✦ 03|宽表不应靠字段多取胜
SchemaKeywordSearchService预先整理表名、表单名称、菜单和字段元数据。关键词命中真实标识、显示名与备注,使用不同权重;完全相同的表名比备注中的偶然出现更有分量。
当前代码的精确匹配权重中,表名为120、表单显示名105、菜单100;字段名58、字段显示名54、备注20。部分匹配采用较低权重。这些数值是排序规则,不是模型的置信度。
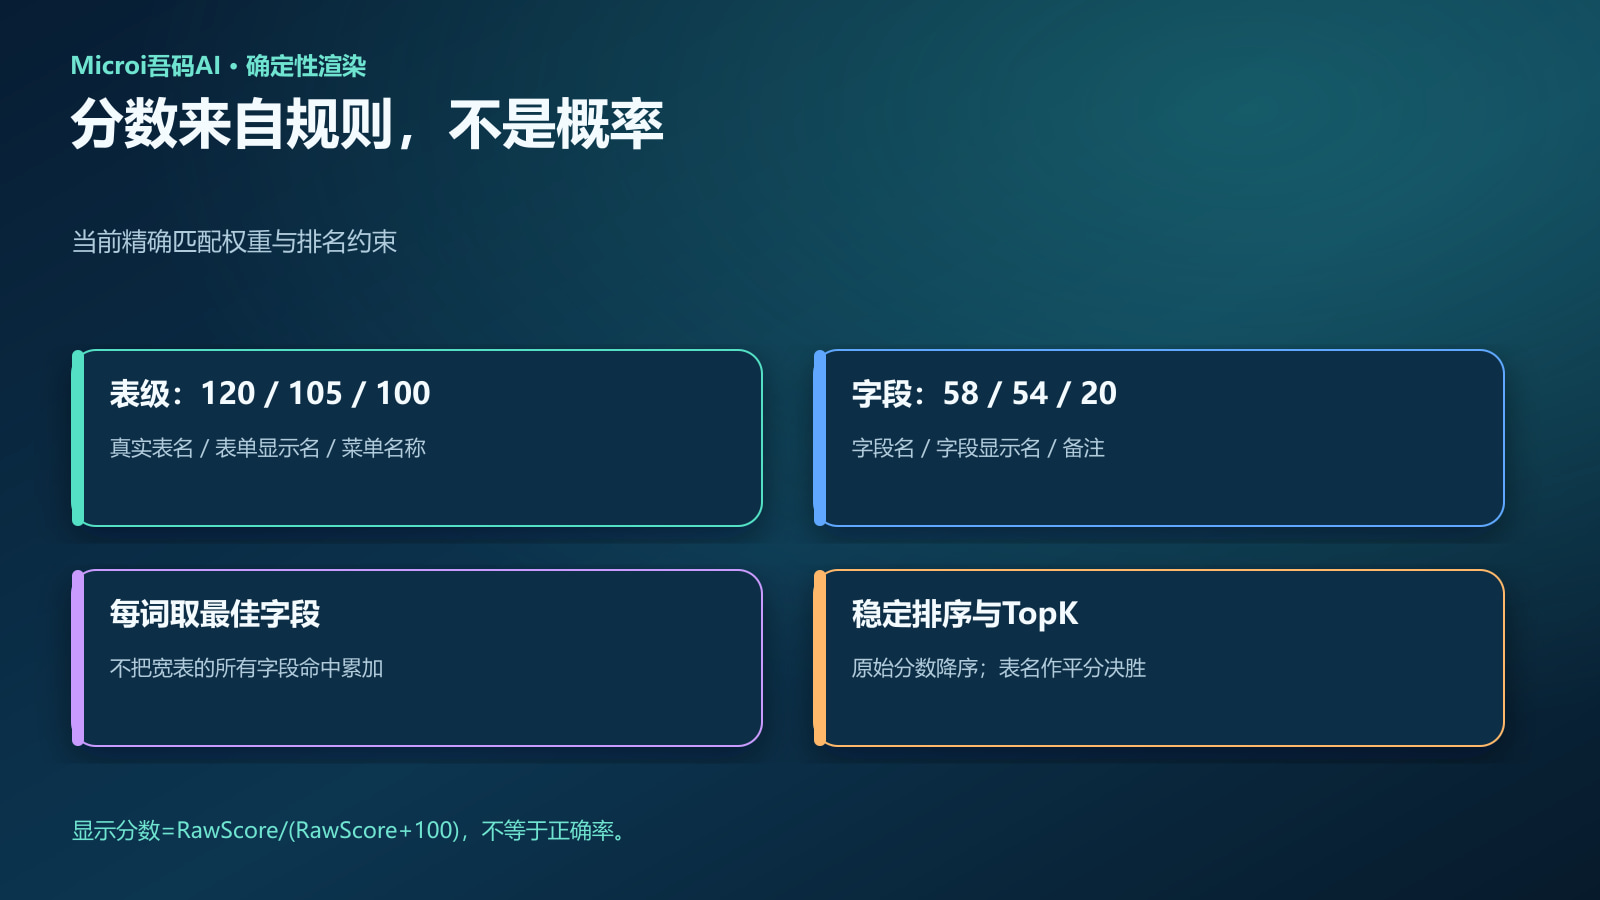
权重摘自当前源码;图中只列精确匹配及排序规则。
容易被忽略的细节| 对每个关键词,字段部分取最佳字段命中的分数,不把整张表所有相似字段一股脑相加。字段多的宽表因此不会仅凭规模占优。
对每个候选表:
  分数 = 表级命中 + 各关键词的最佳字段命中
按原始分数降序,再按表名稳定排序
TopK限制在1到50之间
显示分数 = RawScore / (RawScore + 100)
✦ 04|候选必须先过服务端白名单
“检索到”和“可以给当前用户使用”是两件不同的事。调用链需要从服务端确定实际授权表集合,再对候选过滤;不能把前端传来的表名列表直接当作权限。
这里也要精确理解辅助方法:RankTables收到空集合会返回空结果;收到null则表示该内部调用未施加表过滤。因而不能仅凭一个排序方法,就宣称全链路已自动完成授权。
上线时的检查项| 核对生产调用方传入的授权集合、租户上下文和后续执行权限;检索排序本身不能替代菜单、表、行权限。
- 授权范围在可信服务端生成,检索条件不接受客户端任意扩权。
- 模型看到候选后,仍需取得真实字段与关系,不用扩词结果替代结构。
- 执行继续检查租户、只读语法、表白名单与行数限制;行级范围查询使用经审核的业务接口。
✦ 05|向量能力是一条可选支路
当前EnableVectorDatabase在缺省、空值或关闭时,不调用向量分支。关键词检索可独立工作;启用向量后,结果可与关键词候选融合、去重并按TopK收敛。
向量请求失败时回退关键词召回,体现了职责分离:语义相似度可以补充线索,却不应把基础的元数据定位变成必须依赖外部服务才能工作的功能。
关键词召回:基础路径
向量召回:配置启用后追加
融合:按表标识去重并控制TopK
向量失败:保留关键词结果- 关键词适合真实标识、显示名称和可解释的精确匹配。
- 向量有助于补充语言表达差异,实际收益需要目标业务数据验证。
- 融合后的表与字段依然受授权、真实结构及执行检查约束。
✦ 06|28项测试到底证明了什么
本轮在当前工作区执行SchemaKeywordSearchTests,28项测试通过。它们覆盖字段元数据参与排名、白名单过滤、中文切片、扩词JSON解析、向量关闭或失败后的回退、融合去重,以及相关边界处理。
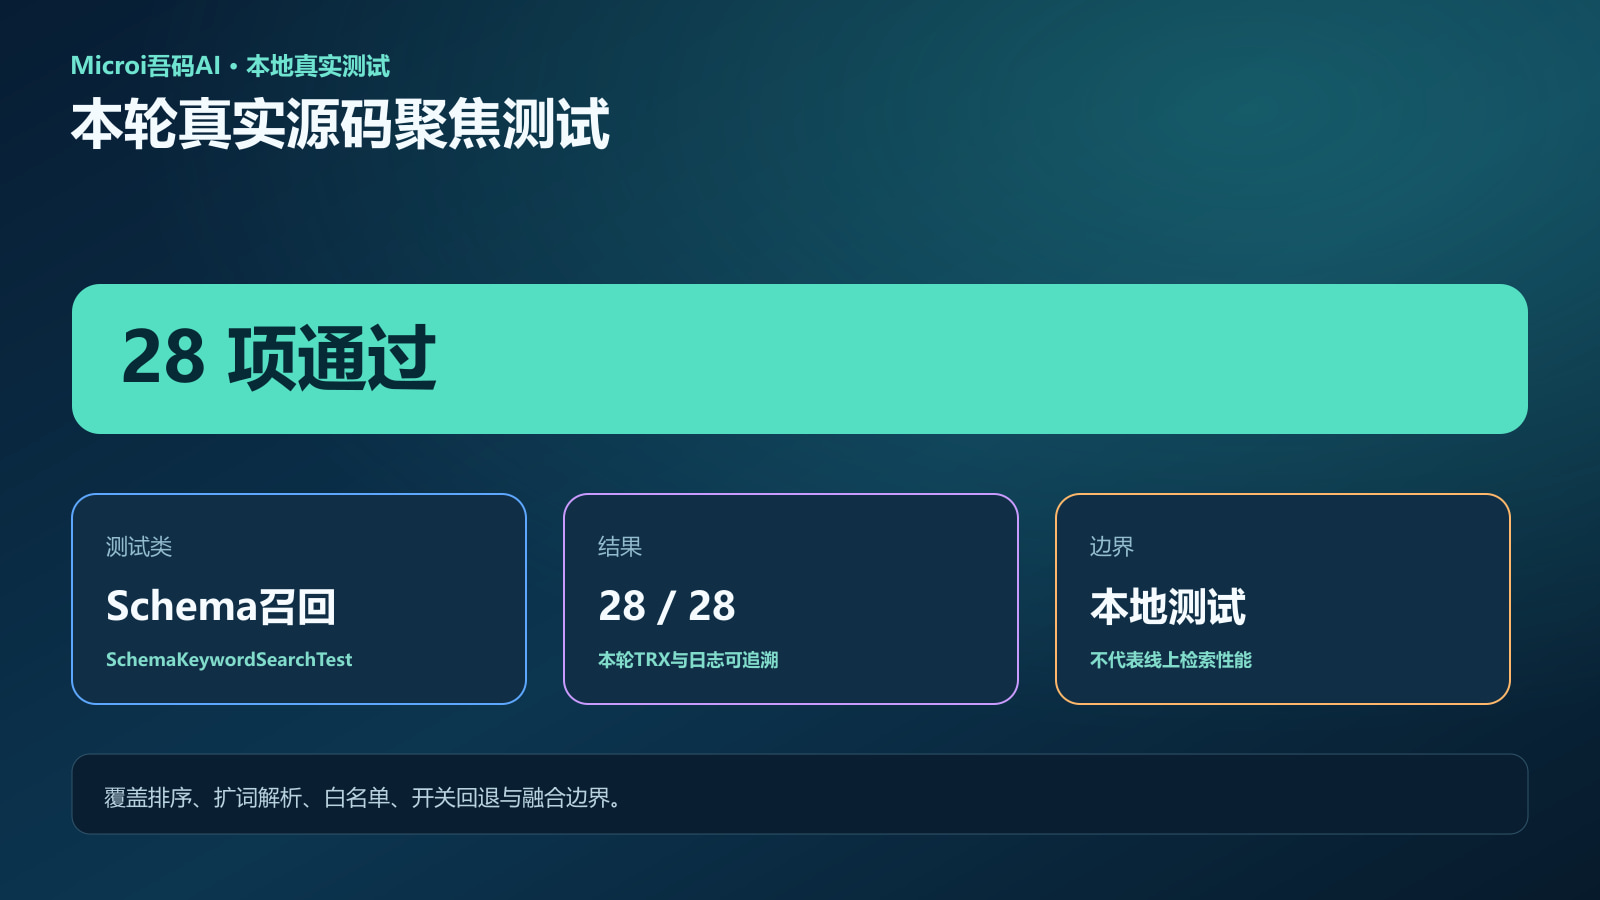
实际结果由本轮TRX与测试日志支持;这是源码聚焦测试,不是业务库压测。
这些测试能验证代码规则与可控输入下的行为。它们没有测量真实模型对复杂问题的命中率,也没有证明某个租户的业务字段登记完整、权限配置正确或线上检索延迟达标。
测试结论| 本地28项通过,支持当前检索规则的行为判断;模型效果、目标租户元数据质量和线上性能仍需各自的证据。
✦ 07|接入前先看登记质量
如果客户表没有准确显示名、最后联系时间缺少字段备注,再漂亮的语义扩词也难以可靠定位。低代码元数据在这里不仅供页面展示,也成为AI理解业务结构的材料。
- 核对关键表是否在表单引擎登记,并有可理解的业务名称。
- 区分创建时间、修改时间、计划联系时间与实际联系时间。
- 为近义但含义不同的字段补充准确备注,避免只写“时间”。
- 用实际业务问题验证候选表,再检查字段与权限;分别记录召回、生成和执行结果。
一个可操作的例子是:先问“很久没有联系的客户”,观察候选是否含客户与跟进记录,再核对用于判断“很久”的真实时间字段。业务定义没有确认前,不应让模型擅自决定天数或客户状态。
✦ 08|把自然语言接到确定的结构上
这次源码拆解给出的启发很具体:让模型承担它擅长的语言展开,让检索服务负责可解释的候选排序,让服务端权限限定范围,再把真实字段交给后续生成与执行。
流程中的每一层都可以单独检查。遇到错误时,可以判断是业务词没展开、元数据没登记、候选排错,还是权限与后续执行的问题。这样的分工,让AI能力能够持续改进,也让排查有落点。
阅读线索| 实现:SchemaKeywordSearchService、AiSchemaKeywordExpansionService;验证:SchemaKeywordSearchTests;平台用法与配置以Microi吾码当前AI引擎文档和Skills为准。
文中已标注的概念图由AI生成;流程图与测试图采用确定性排版。源码分析与本地测试来自当前工作区,不代表线上业务库性能或真实模型回答准确率。Microi吾码AI整理创作。

宁波官方开源宣传和活动阵地,欢迎各位和我们共建开源生态体系!
更多推荐
 2
 0
- 0


 已为社区贡献185条内容

所有评论(0)